
Chmura i bezpieczeństwo16 min czytania3175 słówRedakcja dvnt
SLA — co to jest i co sprawdzić w umowie SLA z dostawcą chmury
SLA co to jest: ile przestoju mieści się w 99,9%, jak wyglądają SLA AWS, Microsoft i Google, SLO, RPO i RTO oraz 10 rzeczy do sprawdzenia w umowie.
SLA — co to jest i dlaczego pojawia się w każdej umowie z dostawcą chmury? Skrót oznacza service level agreement, czyli umowę o poziomie usług: dokument, w którym dostawca zapisuje, jak dobrze jego usługa ma działać i co się stanie, jeśli nie dotrzyma słowa. W usługach w chmurze i SaaS najczęściej chodzi o jedną liczbę — procent dostępności w miesiącu, na przykład 99,9%. Ta liczba wygląda jak obietnica, że usługa prawie nigdy nie przestanie działać. W praktyce oznacza coś znacznie skromniejszego.
Ten tekst dotyczy SLA dostawców chmury, oprogramowania SaaS i usług IT, z których korzysta firma: poczty, pakietów biurowych, serwerów w chmurze. Pokazujemy, ile przestoju mieści się w typowych poziomach SLA, jak wyglądają umowy AWS, Microsoft i Google, czym SLA różni się od SLO, co oznaczają RPO i RTO i jak SLA ma się do polskiego prawa. Na końcu znajdziesz listę 10 rzeczy do sprawdzenia przed podpisaniem umowy. Jeśli szukasz informacji o umowie serwisowej dla firmowej strony internetowej, to osobny temat — opisujemy go w tekście o opiece technicznej nad stroną.
SLA co to jest — definicja i czym SLA nie jest
Najbardziej precyzyjną definicję, którą można przeczytać za darmo, podaje norma ISO/IEC 17788:2014, opublikowana równolegle przez ITU jako zalecenie Y.3500. W punkcie 3.1.7 przejmuje ona definicję z normy o zarządzaniu usługami ISO/IEC 20000-1 (ITU-T Y.3500, 08/2014):
> „service level agreement (SLA): Documented agreement between the service provider and customer that identifies services and service targets.”
W tłumaczeniu własnym: umowa o poziomie usług to udokumentowane porozumienie między dostawcą usługi a klientem, które określa usługi i ich cele. Dwie uwagi do tej definicji są w praktyce równie ważne. Pierwsza: SLA może obowiązywać także między dostawcą a jego podwykonawcą albo działem wewnętrznym. Druga: SLA „can be included in a contract or another type of documented agreement” — może być częścią umowy albo innego dokumentu. W chmurze zwykle jest osobnym dokumentem, do którego regulamin odsyła i który dostawca może aktualizować.
Microsoft w swoim poradniku o czytaniu SLA ujmuje to bardziej praktycznie: SLA to „a contractual commitment between a service provider and a customer, with defined consequences for unmet targets”, czyli zobowiązanie umowne z określonymi konsekwencjami niedotrzymania celów, a jednocześnie „a set of conditional commitments” — zestaw zobowiązań warunkowych (Microsoft Learn, 31.03.2026). Słowo „warunkowych” jest kluczem do całego tematu.
Czym SLA nie jest. SLA nie jest gwarancją, że usługa nie ulegnie awarii. Dostawca nie obiecuje, że przestój się nie zdarzy — obiecuje, co zrobi, jeśli przestój przekroczy uzgodniony limit. Tą konsekwencją w chmurze prawie zawsze jest kredyt usługowy: obniżka przyszłego rachunku, a nie wypłata odszkodowania. Microsoft pisze o tym wprost: „Credits don't cover lost revenue, customer attrition, or reputational damage” (tłumaczenie własne: kredyty nie pokrywają utraconych przychodów, odejścia klientów ani szkód wizerunkowych), a dostawcy „don't usually apply them automatically” — zwykle nie naliczają ich automatycznie.
Ile przestoju mieści się w 99,9% — uptime w minutach
Dostępność (uptime) w SLA to procent czasu, w którym usługa działa, liczony w określonym okresie. Dopuszczalny przestój wylicza się prostym wzorem:
dopuszczalny przestój = (1 − SLA / 100) × liczba minut w okresie
Miesiąc 30-dniowy ma 43 200 minut, rok 365-dniowy — 525 600 minut. Dla 99,9% w miesiącu wychodzi więc 0,001 × 43 200 = 43,2 minuty. Tabela poniżej pokazuje typowe poziomy (obliczenia własne):
Poziom SLA | Przestój w miesiącu (30 dni) | Przestój w roku (365 dni) |
|---|---|---|
99% | 432 min (7,2 h) | 87,6 h |
99,5% | 216 min (3,6 h) | 43,8 h |
99,9% | 43,2 min | 8,76 h |
99,95% | 21,6 min | 4,38 h |
99,99% | 4,32 min | 0,88 h (ok. 53 min) |
Dopuszczalna niedostępność przy typowych poziomach dostępności
| Poziom SLA | Miesiąc (30 dni) | Rok (365 dni) |
|---|---|---|
| 99,0% | Miesiąc (30 dni)432 min (7,2 h) | Rok (365 dni)87,6 h |
| 99,5% | Miesiąc (30 dni)216 min (3,6 h) | Rok (365 dni)43,8 h |
| 99,9% | Miesiąc (30 dni)43,2 min | Rok (365 dni)8,76 h |
| 99,95% | Miesiąc (30 dni)21,6 min | Rok (365 dni)4,38 h |
| 99,99% | Miesiąc (30 dni)4,32 min | Rok (365 dni)0,88 h |
Z tej tabeli płyną dwa wnioski. Po pierwsze, różnica między „dwiema dziewiątkami” a „czterema dziewiątkami” to różnica między ponad siedmioma godzinami a czterema minutami miesięcznie — to nie są kosmetyczne poprawki. Po drugie, dostawcy liczą dostępność w miesiącu, nie w roku. Microsoft Learn: „SLAs usually measure uptime over a billing period, not in real time” (SLA zwykle mierzą dostępność w okresie rozliczeniowym, a nie w czasie rzeczywistym). Roczne 8,76 godziny dla 99,9% to więc tylko przeliczenie poglądowe. Dostawca może zmieścić się w SLA co miesiąc, a jedna awaria trwająca 40 minut w złym momencie — na przykład w dniu zamknięcia miesiąca — i tak zatrzyma twoją firmę.
Tabela nie pokazuje też, co dostawca liczy jako przestój — a wyłączenia i definicja „niedostępności” potrafią sprawić, że realny przestój jest dłuższy niż ten w statystyce SLA.
Jak wyglądają umowy SLA dużych dostawców
Poniżej trzy dokumenty w wersjach dostępnych 30 września 2026 roku.
AWS: Amazon Compute SLA (EC2)
Dokument dla serwerów wirtualnych EC2 ma datę „Last Updated: May 25, 2022” (AWS). Zawiera dwa poziomy zobowiązań:
- 99,99% na poziomie regionu — dotyczy instancji rozmieszczonych w co najmniej dwóch strefach dostępności;
- 99,5% na poziomie pojedynczej instancji.
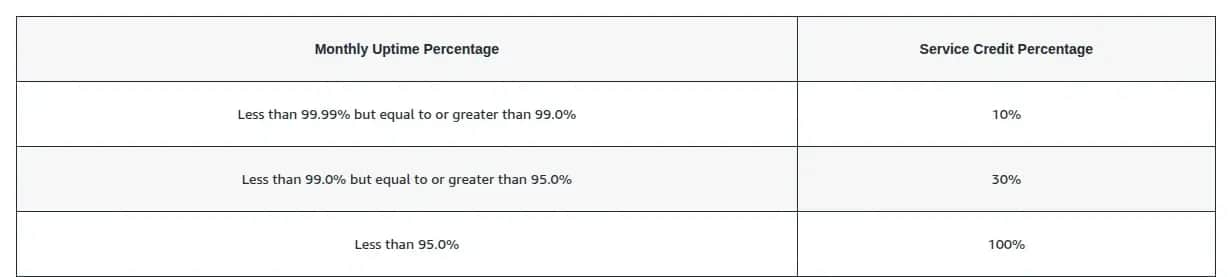
Rekompensaty to procent opłat: dla regionu 10% przy dostępności poniżej 99,99%, ale co najmniej 99,0%; 30% przy dostępności poniżej 99,0%, ale co najmniej 95,0%; 100% poniżej 95,0%. Dla pojedynczej instancji pierwszy próg to przedział od 99,0% do poniżej 99,5%, kolejne są takie same. Dodatkowo AWS nie pobiera opłaty za pojedynczą instancję niedostępną dłużej niż sześć minut w danej godzinie zegarowej — i to jedyny element, który działa automatycznie.
Resztę trzeba wywalczyć samemu. Kredyt przyznawany jest po zgłoszeniu w AWS Support Center, które musi wpłynąć do końca drugiego cyklu rozliczeniowego po incydencie. Kredyt wydawany jest tylko, jeśli przekracza jednego dolara, i zalicza się wyłącznie na przyszłe płatności: „Service Credits will not entitle you to any refund” — kredyty nie dają prawa do zwrotu pieniędzy. SLA nie obejmuje m.in. niedostępności wynikającej z siły wyższej, problemów z internetem poza granicą infrastruktury EC2 oraz działań, zaniechań, sprzętu lub oprogramowania klienta. Najważniejsze zdanie stoi na końcu: SLA określa „your sole and exclusive remedies” — jedyne i wyłączne środki, jakie klientowi przysługują w razie niedostępności.
Microsoft: Umowa dotycząca Poziomu Usług Online
Microsoft publikuje zbiorczy dokument dla usług online, także po polsku: „Umowa dotycząca Poziomu Usług Online Microsoft, 1 września 2026 r.” (Microsoft, SLA for Online Services). Polska wersja pozwala zacytować klauzulę wyłącznego środka w brzmieniu, które podpisuje polski klient:
> „Środki na Używanie Usług stanowią jedyne uprawnienie przysługujące Klientowi z tytułu problemów z wydajnością lub dostępnością dotyczących dowolnej Usługi w ramach Umowy i niniejszej umowy SLA.”
Dokument dodaje, że klient nie może jednostronnie potrącać tych kwot z opłat, że kredyty w żadnym wypadku nie mogą przekroczyć miesięcznych opłat za daną usługę i że nie będą przyznawane jako rekompensata innych strat, „w tym między innymi utraconych przychodów, kosztów operacyjnych lub jakichkolwiek pośrednich strat”.
Ważne jest też wyłączenie prac planowych. „Planowany przestój” to przestój związany z konserwacją lub aktualizacjami, o którym dokument mówi: „Opublikujemy powiadomienie lub powiadomimy użytkowników co najmniej pięć (5) dni przed rozpoczęciem takiego Przestoju.” Taki przestój nie wlicza się do przestoju objętego SLA. (Uwaga redakcyjna: polski tekst sam jest tu niespójny i w jednym miejscu mówi o „Planowanym”, w innym o „Zaplanowanym” przestoju.) Dla niektórych usług Microsoft rezygnuje z tego wyłączenia: przy Exchange Online dokument stwierdza, że „nie ma Planowego Przestoju”.
Poziomy dla usług, z których korzysta większość firm: Exchange Online i Teams — 99,9%, z kredytem 25% poniżej 99,9%, 50% poniżej 99% i 100% poniżej 95%. Przy Exchange przestój oznacza okres, w którym użytkownicy nie mogą wysyłać ani odbierać poczty w przeglądarce (Outlook Web App). Termin reklamacji dla Azure to 60 dni od incydentu, dla pozostałych usług — koniec okresu rozliczeniowego następującego po miesiącu incydentu; rozpatrzenie trwa zwykle do 45 dni. Wersje próbne (preview) i bezpłatne plany nie są objęte SLA.
Google Workspace SLA
Dokument Google ma datę „Last modified: August 31, 2026” i — według naszego sprawdzenia — nie ma wersji polskiej; adres z /intl/pl/ wyświetla tekst angielski (Google Workspace SLA). Zobowiązanie: miesięczna dostępność „at least 99.9% in any calendar month”.
Google liczy rekompensaty inaczej niż AWS i Microsoft — w dniach usługi: 3 dni przy dostępności poniżej 99,9% (ale co najmniej 99,0%), 7 dni poniżej 99,0% (co najmniej 95,0%) i 15 dni poniżej 95,0%. Łączny kredyt w miesiącu nie może przekroczyć 15 dni. Klienci rozliczani przez fakturę offline dostają dni doliczone na końcu okresu umowy, klienci płacący online — kredyt pieniężny odpowiadający tym dniom na przyszłej fakturze.
Przestój to okres, w którym interfejs webowy usługi ma więcej niż pięć procent błędów użytkownika. Zgłoszenie trzeba złożyć w ciągu 30 dni od momentu, gdy klient nabył prawo do kredytu — po tym terminie prawo przepada. Także tu SLA jest „Customer's sole and exclusive remedy”. Ciekawostka: dokument nie zawiera wyłączenia prac planowych — przeszukanie pełnego tekstu nie znalazło takiego zapisu.
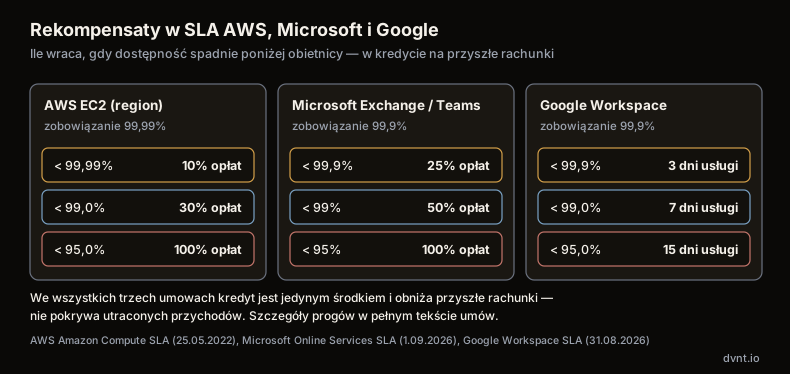
Co łączy wszystkie trzy dokumenty. Rekompensata ma postać kredytu na przyszłe usługi, trzeba się o nią upomnieć w określonym terminie, ma górny limit i jest jedynym środkiem, jaki umowa przewiduje. Kredyt w wysokości nawet 100% miesięcznej opłaty za pocztę to zwykle ułamek tego, ile kosztuje firmę dzień bez poczty.
SLA a SLO i SLI — trzy pojęcia, które łatwo pomylić
W rozmowach o niezawodności obok SLA pojawiają się dwa inne skróty. Najczęściej cytowane definicje pochodzą z książki Google o inżynierii niezawodności (Site Reliability Engineering), z rozdziału o celach poziomu usług (Google SRE Book):
- SLI — „An SLI is a service level indicator—a carefully defined quantitative measure of some aspect of the level of service that is provided.” Tłumaczenie własne: wskaźnik poziomu usługi, czyli starannie zdefiniowana, liczbowa miara jakiegoś aspektu świadczonej usługi — na przykład odsetek udanych zapytań albo czas odpowiedzi.
- SLO — „An SLO is a service level objective: a target value or range of values for a service level that is measured by an SLI.” Tłumaczenie własne: cel poziomu usługi, czyli docelowa wartość lub przedział wartości mierzony wskaźnikiem SLI.
- SLA — „SLAs are service level agreements: an explicit or implicit contract with your users that includes consequences of meeting (or missing) the SLOs they contain.” Tłumaczenie własne: umowa o poziomie usług, jawna lub dorozumiana, która obejmuje konsekwencje osiągnięcia (lub nieosiągnięcia) zawartych w niej celów SLO.
Autorzy podają prosty test: zapytaj, „what happens if the SLOs aren't met?” — co się stanie, jeśli cele nie zostaną osiągnięte. Jeśli nie ma wyraźnej konsekwencji, to prawie na pewno masz przed sobą SLO, a nie SLA.
Dla klienta ta różnica ma praktyczne znaczenie: deklaracja w stylu „dążymy do 99,95% dostępności” opisuje SLO, czyli cel. Wiąże dopiero dokument, w którym liczba łączy się z konsekwencją.
RPO i RTO — ile danych i ile czasu możesz stracić
SLA mówi o dostępności: jak długo usługa może nie działać. Nie mówi natomiast nic o tym, ile danych stracisz po poważnej awarii ani jak szybko wrócisz do pracy po katastrofie. Do tego służą dwa inne pojęcia, najlepiej opisane w publikacji NIST SP 800-34 Rev. 1 o planowaniu ciągłości działania systemów IT, w części o analizie wpływu na działalność (NIST SP 800-34 Rev. 1, maj 2010, s. 17):
> „Recovery Time Objective (RTO). RTO defines the maximum amount of time that a system resource can remain unavailable before there is an unacceptable impact on other system resources, supported mission/business processes, and the MTD.”
Tłumaczenie własne: RTO (docelowy czas odtworzenia) określa maksymalny czas, przez jaki zasób systemu może pozostawać niedostępny, zanim nastąpi niedopuszczalny wpływ na inne zasoby, wspierane procesy biznesowe i MTD — maksymalny tolerowany czas przestoju procesu biznesowego.
> „Recovery Point Objective (RPO). The RPO represents the point in time, prior to a disruption or system outage, to which mission/business process data can be recovered (given the most recent backup copy of the data) after an outage.”
Tłumaczenie własne: RPO (docelowy punkt odtworzenia) to moment sprzed zakłócenia lub awarii, do którego — na podstawie najnowszej kopii zapasowej — można odtworzyć dane procesu biznesowego. NIST dodaje, że RPO wyraża to, ile utraty danych proces biznesowy może znieść.
W skrócie: RTO odpowiada na pytanie „jak długo”, RPO — „z jakiego momentu”. Jeśli kopia zapasowa robiona jest raz na dobę, RPO wynosi w najgorszym razie 24 godziny: wszystko, co wprowadzono od ostatniej kopii, trzeba będzie odtworzyć ręcznie albo przepadnie. Żaden z trzech opisanych wyżej dokumentów SLA nie zawiera zobowiązań RPO ani RTO dla danych klienta — mówią o dostępności usługi, a nie o odzyskaniu twoich danych. Te parametry trzeba ustalić osobno albo zapewnić samodzielnie. Jak zaplanować kopie i odtwarzanie dla strony internetowej, opisujemy w tekście o kopii zapasowej strony.
SLA a polskie prawo
Umowa SLA z zagranicznym dostawcą podlega prawu wskazanemu w umowie głównej, ale punktem odniesienia dla polskiej firmy jest Kodeks cywilny. Cytujemy tekst jednolity (Dz.U. 2026 poz. 795). Ta część nie jest poradą prawną.
Art. 471 — zasada ogólna. „Dłużnik obowiązany jest do naprawienia szkody wynikłej z niewykonania lub nienależytego wykonania zobowiązania, chyba że niewykonanie lub nienależyte wykonanie jest następstwem okoliczności, za które dłużnik odpowiedzialności nie ponosi.” Bez żadnego SLA dostawca odpowiadałby więc na zasadach ogólnych za szkodę wynikłą z nienależytego wykonania usługi.
Art. 473 — granice umownej zmiany odpowiedzialności. Strony mogą umownie modyfikować zakres odpowiedzialności, ale § 2 stawia twardą granicę: „Nieważne jest zastrzeżenie, iż dłużnik nie będzie odpowiedzialny za szkodę, którą może wyrządzić wierzycielowi umyślnie.” Klauzule typu „kredyt jest jedynym środkiem” ograniczają odpowiedzialność — a art. 473 § 2 pokazuje, że w polskim prawie takie ograniczenia nie są nieograniczone.
Art. 483 i 484 — kara umowna. Zgodnie z art. 483 § 1 „można zastrzec w umowie, że naprawienie szkody wynikłej z niewykonania lub nienależytego wykonania zobowiązania niepieniężnego nastąpi przez zapłatę określonej sumy (kara umowna)”. Art. 484 § 1 dodaje, że kara należy się „bez względu na wysokość poniesionej szkody”, a żądanie odszkodowania przenoszącego jej wysokość „nie jest dopuszczalne, chyba że strony inaczej postanowiły”. Według § 2 dłużnik może żądać zmniejszenia kary, gdy zobowiązanie zostało w znacznej części wykonane albo kara jest rażąco wygórowana.
Czy kredyt usługowy to kara umowna? Tu się zatrzymujemy. Kredyt przypomina karę umowną — z góry ustalona kwota za nienależyte wykonanie — ale ma postać obniżki przyszłych opłat, a nie zapłaty „określonej sumy”. Nie znaleźliśmy źródła, które rozstrzygałoby tę kwalifikację w jedną lub drugą stronę. Jeśli od dostępności usługi zależy istotna część przychodu twojej firmy, to jest dokładnie to pytanie, które warto zadać prawnikowi przed podpisaniem umowy — razem z pytaniem o prawo właściwe i sąd.
DORA — tylko dla sektora finansowego. Rozporządzenie (UE) 2022/2554, stosowane od 17 stycznia 2025 roku (art. 64), w art. 30 stanowi, że umowa podmiotu finansowego z dostawcą usług ICT „obejmuje klauzule o gwarantowanym poziomie usług” i zawiera m.in. „opisy gwarantowanych poziomów usług, w tym ich aktualizacje i zmiany” (ust. 2 lit. e). Przy funkcjach krytycznych lub istotnych wymagane są pełne opisy z „dokładnymi ilościowymi i jakościowymi celami w zakresie wyników” (ust. 3 lit. a) oraz m.in. strategie wyjścia z okresem przejściowym (DORA, tekst polski). DORA dotyczy wyłącznie podmiotów finansowych i ich umów ICT — nie jest ogólnym wymogiem dla każdej umowy SaaS. Dla pozostałych firm to jednak dobra lista kontrolna.
NIS2 — pośrednio. Dyrektywa 2022/2555 nie wymienia SLA z nazwy, ale w art. 21 ust. 2 wymaga od objętych nią podmiotów środków obejmujących m.in. „ciągłość działania, np. zarządzanie kopiami zapasowymi i przywracanie normalnego działania po wystąpieniu sytuacji nadzwyczajnej” (lit. c) oraz „bezpieczeństwo łańcucha dostaw, w tym aspekty związane z bezpieczeństwem dotyczące stosunków między każdym podmiotem a jego bezpośrednimi dostawcami lub usługodawcami” (lit. d) (NIS2, tekst polski). W Polsce dyrektywę wdraża ustawa z 23 stycznia 2026 roku o zmianie ustawy o krajowym systemie cyberbezpieczeństwa (Dz.U. 2026 poz. 252), w mocy od 3 kwietnia 2026 roku. Czy zawiera ona szczegółowe wymogi dotyczące umów z dostawcami, nie weryfikowaliśmy.
10 rzeczy do sprawdzenia w umowie SLA przed podpisaniem
Wszystko powyżej sprowadza się do listy. Dotyczy ona każdej umowy SLA — z dużym dostawcą chmury, z mniejszą firmą SaaS i z dostawcą usług IT:
- Wyłączenia. Co nie liczy się jako przestój: siła wyższa, problemy z internetem, działania klienta, zawieszenie konta. Im szersza lista, tym mniej warte są dziewiątki.
- Prace planowe. Czy są wyłączone z liczenia dostępności, z jakim wyprzedzeniem dostawca je zapowiada (u Microsoftu co najmniej 5 dni) i czy jest limit ich długości. U niektórych dostawców wyłączenia w ogóle nie ma.
- Sposób pomiaru. Co dokładnie znaczy „niedostępność”: brak odpowiedzi serwera, odsetek błędów (u Google powyżej 5%), niemożność wysłania poczty? W jakim okresie liczy się procent — miesiąc kalendarzowy czy okres rozliczeniowy?
- Termin i forma reklamacji. U AWS do końca drugiego cyklu rozliczeniowego, u Google 30 dni, u Microsoftu dla Azure 60 dni. Kredyty zwykle nie są naliczane automatycznie — ktoś w firmie musi pilnować zgłoszeń.
- Limit rekompensat. Najczęściej 100% miesięcznej opłaty za usługę (Microsoft) albo 15 dni usługi (Google) — niezależnie od tego, ile trwała awaria.
- Klauzula wyłącznego środka. Czy SLA stanowi, że kredyt jest jedynym uprawnieniem klienta? Wszyscy trzej opisani dostawcy tak to formułują. To oznacza, że z SLA nie wynika odszkodowanie za utracone przychody.
- Czas reakcji wsparcia. Dostępność to jedno, a to, jak szybko ktoś odpowie na zgłoszenie awarii, to drugie. Sprawdź, czy czasy reakcji są w umowie, czy tylko na stronie z cennikiem planów wsparcia.
- RPO i RTO. Czy dostawca w ogóle deklaruje, z jakiego momentu i w jakim czasie odtworzy twoje dane? Jeśli nie — zakładaj, że musisz to zapewnić sam.
- Raporty dostępności. Czy dostawca publikuje historię dostępności i incydentów, czy musisz mierzyć ją sam, żeby w ogóle wiedzieć, że przysługuje ci kredyt?
- Zmiana dostawcy. Co się dzieje z danymi po wypowiedzeniu umowy, w jakim formacie i terminie je odzyskasz. Szerzej o strategii wyjścia i obowiązkach dostawców z Aktu w sprawie danych piszemy w tekście o bezpieczeństwie danych w chmurze.
SLA w małej firmie — co wynegocjujesz, a co musisz zabezpieczyć sam
Uczciwa odpowiedź brzmi: z dużym dostawcą chmury mała firma zwykle niczego nie wynegocjuje. SLA AWS, Microsoftu i Google to dokumenty standardowe, akceptowane razem z regulaminem, a ich zmiany publikuje dostawca. Negocjacje są możliwe przede wszystkim z mniejszymi dostawcami SaaS, lokalnymi firmami IT i wykonawcami oprogramowania tworzonego na zamówienie. Tam warto rozmawiać o czasie reakcji na zgłoszenia, o kanale zgłaszania awarii poza godzinami pracy, o parametrach kopii zapasowych i o tym, w jakiej formie dostaniesz dane przy rozstaniu. Wybór między gotową usługą a własnym systemem — i związane z tym różnice w odpowiedzialności — opisujemy też w tekście o on-premise.
Skoro kredyt nie pokryje strat, to realną ochronę daje to, co firma zrobi sama. Trzy rzeczy mają największe znaczenie:
- Własny monitoring. Jeśli nie wiesz, kiedy usługa nie działała, nie złożysz reklamacji w terminie ani nie zweryfikujesz raportu dostawcy. Prosty zewnętrzny monitoring dostępności pokazuje przestój z twojej perspektywy, a nie z perspektywy statystyki dostawcy. Jak to działa w przypadku stron internetowych, opisujemy w tekście o monitoringu strony.
- Własne kopie zapasowe. SLA dotyczy dostępności usługi, nie twoich danych. Kopia w innym miejscu niż sama usługa to jedyny sposób, żeby RPO zależało od ciebie, a nie od dostawcy — patrz kopia zapasowa strony.
- Plan B na kilka godzin. Dla procesów, które nie mogą stanąć — obsługa zamówień, kontakt z klientami, płatności — warto wiedzieć z góry, co zrobisz, gdy usługa nie działa przez pół dnia: alternatywny kanał kontaktu, lista zamówień poza systemem, osoba odpowiedzialna za komunikat do klientów.
Jeśli SLA, które cię interesuje, dotyczy firmowej strony internetowej, a nie usługi w chmurze, to w praktyce rozmawiasz o umowie serwisowej: czasie reakcji, aktualizacjach, kopiach i monitoringu. Ten temat opisujemy w tekście o opiece technicznej nad stroną, a orientacyjny koszt takiej opieki pokaże kalkulator kosztu utrzymania strony.
Co dalej
Czym jest chmura obliczeniowa i czym różnią się modele IaaS, PaaS i SaaS — a więc za które warstwy odpowiada dostawca objęty SLA — wyjaśniamy w tekście o chmurze obliczeniowej. Szerzej o samym modelu SaaS piszemy w przewodniku po SaaS. Jeśli wybierasz dostawcę dla kluczowego systemu i chcesz przejść przez umowę z kimś, kto zna techniczną stronę tematu, zajrzyj do naszego doradztwa technologicznego.
Najczęstsze pytania o SLA
Co to jest SLA w prostych słowach?
SLA (service level agreement, umowa o poziomie usług) to dokument, w którym dostawca usługi zapisuje, jak dobrze ma ona działać — w chmurze najczęściej jako procent dostępności w miesiącu, np. 99,9% — i co się stanie, jeśli tego poziomu nie dotrzyma. SLA nie gwarantuje, że awarii nie będzie. Określa tylko konsekwencje przekroczenia limitu przestoju, zwykle w formie obniżki przyszłego rachunku.
Ile przestoju oznacza SLA 99,9%?
W miesiącu 30-dniowym SLA 99,9% dopuszcza 43,2 minuty przestoju, co w przeliczeniu na rok daje 8,76 godziny. Wzór: (1 − SLA/100) × liczba minut w okresie. Dostawcy liczą dostępność zwykle w miesiącu lub okresie rozliczeniowym, a prace planowe i inne wyłączenia opisane w umowie często nie wliczają się do przestoju.
Czy SLA daje prawo do odszkodowania za awarię?
Zwykle nie. SLA AWS, Microsoftu i Google przewidują kredyt usługowy — procent opłaty lub kilka dni usługi zaliczane na przyszłe rachunki — i stanowią, że jest on jedynym środkiem przysługującym klientowi. Microsoft wprost wyklucza rekompensatę utraconych przychodów. Kredyt trzeba zgłosić w terminie z umowy. Czy taki kredyt ma charakter kary umownej w rozumieniu Kodeksu cywilnego, to pytanie do prawnika.
Czym różni się SLA od SLO?
Według Google SRE SLO (service level objective) to docelowa wartość poziomu usługi mierzona wskaźnikiem SLI, a SLA to umowa, która łączy SLO z konsekwencjami ich niedotrzymania. Prosty test: jeśli nie wiadomo, co się stanie, gdy cel nie zostanie osiągnięty, to jest to SLO, a nie SLA.
Co oznaczają RPO i RTO?
Według NIST SP 800-34 RTO (recovery time objective) to maksymalny czas, przez jaki system może być niedostępny, zanim wpływ na działalność stanie się niedopuszczalny. RPO (recovery point objective) to moment sprzed awarii, do którego da się odtworzyć dane z najnowszej kopii — czyli ile danych firma może stracić. SLA dostawców chmury mówią o dostępności usługi i zwykle nie zawierają zobowiązań RPO ani RTO dla danych klienta.
Powiązane artykuły
Chmura i bezpieczeństwo
On premise — co to znaczy i kiedy własny serwer w firmie wygrywa z chmurą
On premise, czyli własny serwer w firmie: pełny koszt z amortyzacją i licencjami, koniec wsparcia Windows Server 2016, kiedy wygrywa chmura, a kiedy VPS.
Chmura i bezpieczeństwo
Chmura obliczeniowa — co to jest i czym różnią się IaaS, PaaS i SaaS
Chmura obliczeniowa według definicji NIST: pięć cech, IaaS, PaaS i SaaS, chmura publiczna, prywatna i hybrydowa oraz dane o firmach w Polsce i UE.
Chmura i bezpieczeństwo
Bezpieczeństwo danych w chmurze — kto za co odpowiada i o co pytać dostawcę
Bezpieczeństwo danych w chmurze: co zostaje po Twojej stronie, umowa powierzenia wg RODO, dane poza UE, ISO 27001, NIS2 i 10 pytań do dostawcy.
SaaS i własny produkt
Multi-tenant — co to jest i jak wybrać architekturę SaaS dla wielu klientów
Multi-tenant, czyli wielu klientów w jednej aplikacji: single tenant a multi-tenant, modele silo/pool/bridge, Row Level Security, RODO i wybór modelu dla MVP.
Automatyzacja i integracje
API — co to jest? REST API, webhook i OpenAPI wyjaśnione dla firmy
API co to jest: definicja na przykładach NBP, GUS i białej listy VAT, REST API, webhook, OpenAPI, klucze API i bezpieczeństwo integracji.
Sztuczna inteligencja
RAG AI — jak sztuczna inteligencja odpowiada na podstawie dokumentów firmy
RAG AI to sposób, w jaki model językowy odpowiada na podstawie dokumentów firmy. Jak działa, co psuje odpowiedzi, ile kosztuje i jak zacząć bez ryzyka.
Budujecie system i nie wiecie, gdzie go postawić?
Opowiedzcie, co ma działać i jakie dane będzie przechowywać. Doradzimy, czy wystarczy gotowa usługa w chmurze, czy potrzebny jest własny system — i gdzie go utrzymywać. Jeśli wystarczy gotowy SaaS — powiemy to wprost.