
Sztuczna inteligencja19 min czytania3647 słówRedakcja dvnt
RAG AI — jak sztuczna inteligencja odpowiada na podstawie dokumentów firmy
RAG AI to sposób, w jaki model językowy odpowiada na podstawie dokumentów firmy. Jak działa, co psuje odpowiedzi, ile kosztuje i jak zacząć bez ryzyka.
RAG AI (retrieval-augmented generation, czyli generowanie wspomagane wyszukiwaniem) to sposób, w którym zanim model AI odpowie, system wyszukuje pasujące fragmenty dokumentów firmy i podaje je modelowi razem z pytaniem. Model odpowiada na ich podstawie i może wskazać, z którego dokumentu korzystał. Tak opisuje to Anthropic, twórca modeli Claude, w tekście „Introducing Contextual Retrieval” z 19.09.2024: RAG wyszukuje odpowiednie informacje w bazie wiedzy i dołącza je do polecenia użytkownika.
Po co to firmie? Model językowy nie zna Twoich procedur, umów, cennika ani dokumentacji produktu, a jego wiedza kończy się na danych, na których go wytrenowano. OpenAI w przewodniku „Optimizing LLM accuracy” (odczyt 3.10.2026) wymienia trzy sytuacje, w których modelowi brakuje wiedzy: informacji nie było w danych treningowych, jest nieaktualna albo jest firmowa. RAG odpowiada na wszystkie trzy, a wiedzę aktualizujesz, wymieniając dokumenty, nie trenując model od nowa.
Przed decyzją warto wiedzieć trzy rzeczy. O jakości odpowiedzi decydują bardziej dokumenty i uprawnienia niż sam model. Koszt API jest mały w porównaniu z kosztem przygotowania. Halucynacje maleją, ale nie znikają. Stan dokumentacji i cen na 3.10.2026.
RAG — co to jest (retrieval-augmented generation)
Termin „RAG” pochodzi z pracy naukowej z 2020 r., a dziś oznacza wzorzec budowy systemu, nie konkretny produkt. Zespół badaczy (Lewis i in.) opisał go w pracy „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”, przyjętej na konferencję NeurIPS 2020. Punkt wyjścia autorów: duże modele językowe przechowują wiedzę w swoich parametrach, ale mają ograniczoną zdolność precyzyjnego sięgania po nią, a wskazanie źródła odpowiedzi i aktualizacja wiedzy o świecie pozostawały otwartymi problemami badawczymi. Taki model nie potrafi łatwo poszerzyć ani poprawić swojej pamięci i może halucynować, czyli podawać nieprawdę jako fakt.
Rozwiązanie autorów: połączyć pamięć zapisaną w parametrach modelu z pamięcią zewnętrzną, czyli indeksem dokumentów przeszukiwanym przy każdym pytaniu. W pracy była to Wikipedia. Taką zewnętrzną pamięć da się przeczytać i wymienić: autorzy piszą, że wiedzę systemu można aktualizować, edytując indeks dokumentów. W ich testach model z wyszukiwaniem tworzył tekst bardziej konkretny i bardziej zgodny z faktami niż model bez wyszukiwania. Bardziej, nie bezbłędnie — to rozróżnienie wraca w sekcji o halucynacjach.
Obok definicji Anthropic z początku tekstu dwie inne, od dostawców chmury:
- Google Cloud używa pojęcia grounding (ugruntowanie): łączenie odpowiedzi modelu z weryfikowalnymi źródłami informacji, które zmniejsza szanse, że model coś wymyśli („Grounding overview”, aktualizacja 1.10.2026).
- Microsoft: RAG to wzorzec, który rozszerza możliwości modelu, opierając odpowiedzi na treściach firmy; koncepcyjnie prosty, ale przy wdrożeniu napotyka poważne trudności („RAG and generative AI — Azure AI Search”, aktualizacja 4.08.2026).
Dla firmy oznacza to wybór: RAG albo kupujesz jako funkcję gotowego produktu (asystent w pakiecie biurowym, który przeszukuje Twoje pliki, albo narzędzie wyszukiwania u dostawcy modelu), albo budujesz jako własny system na własnych danych. Mechanizm jest w obu przypadkach ten sam i te same rzeczy go psują.
Jak działa RAG: fragmenty, embeddingi, wyszukiwanie i odpowiedź ze źródłem
RAG ma dwa etapy: przygotowanie bazy wiedzy, które powtarzasz przy każdej zmianie dokumentów, i obsługę pytania, która odbywa się za każdym razem, gdy ktoś pyta.
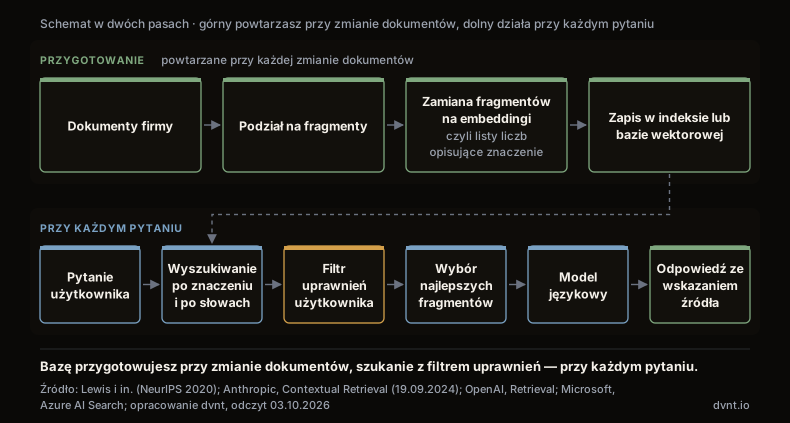
Przygotowanie. Dokumenty dzieli się na fragmenty. Ten podział nazywa się chunking (od angielskiego chunk, czyli kawałek). Anthropic pisze, że fragmenty mają zwykle nie więcej niż kilkaset tokenów (token to jednostka tekstu, w której modele i cenniki mierzą długość tego, co do modelu wysyłasz, i tego, co model zwraca). OpenAI w swoim narzędziu domyślnie tnie pliki na fragmenty po 800 tokenów, z nakładką 400 tokenów między sąsiednimi fragmentami („Retrieval”, odczyt 3.10.2026). Autorzy pracy z 2020 r. dzielili Wikipedię na fragmenty po 100 słów. W projekcie bazy wiedzy czatu na naszej stronie przyjęliśmy około 800 tokenów z nakładką 100. Jednej dobrej wielkości nie ma: Anthropic zaznacza, że wielkość fragmentów, ich granice i nakładka wpływają na jakość wyszukiwania, i radzi sprawdzać to testami.
Każdy fragment zamienia się potem w embedding (osadzenie), czyli listę liczb opisującą znaczenie tekstu. OpenAI definiuje go jako wektor liczb, w którym odległość między dwoma wektorami mierzy pokrewieństwo tekstów: mała odległość oznacza teksty bliskie znaczeniowo, duża — odległe („Vector embeddings”, odczyt 3.10.2026). Embeddingi trafiają do indeksu, często do bazy wektorowej (wektorowej bazy danych), która pozwala szukać po podobieństwie znaczenia. Anthropic nie ma własnego modelu do embeddingów; w dokumentacji wskazuje jako jednego z dostawców Voyage AI i radzi porównać kilku pod kątem własnego zastosowania.
Obsługa pytania. Pytanie też zamienia się w embedding, a system szuka fragmentów o najbliższym znaczeniu. To wyszukiwanie semantyczne, czyli po znaczeniu, a nie po słowach. OpenAI pokazuje je na przykładzie: do pytania „Kiedy polecieliśmy na Księżyc?” najlepiej pasuje zdanie „Pierwsze lądowanie na Księżycu odbyło się w lipcu 1969 r.”, choć nie ma w nim żadnego słowa z pytania.
Wyszukiwanie po znaczeniu ma słaby punkt: dokładne ciągi znaków. Anthropic podaje przykład kodu błędu „TS-999” — model embeddingów może znaleźć ogólne treści o kodach błędów i pominąć dokładnie ten. Dlatego dobre systemy RAG łączą wyszukiwanie po znaczeniu z wyszukiwaniem po słowach. Ma to znaczenie przy numerach umów, symbolach produktów i sygnaturach spraw. Często dochodzi jeszcze reranking (ponowne sortowanie): dodatkowy krok, który spośród znalezionych fragmentów przepuszcza do modelu tylko najtrafniejsze. Anthropic zaznacza, że wydłuża on nieco czas odpowiedzi.
Wybrane fragmenty trafiają do polecenia razem z pytaniem, a model odpowiada na ich podstawie i może wskazać źródło. Anthropic w dokumentacji funkcji Citations gwarantuje, że cytat zwrócony przez API zawiera poprawny wskaźnik do podanego dokumentu. To gwarancja pochodzenia, nie prawdziwości: cytat dowodzi, że fragment istnieje w dokumencie, a nie że model dobrze go zrozumiał ani że dokument jest aktualny.
Na schemacie jest jeszcze krok, który łatwo pominąć: filtr uprawnień przed wyborem fragmentów. Wracamy do niego niżej.
RAG, dostrajanie czy cały dokument w poleceniu — kiedy co
RAG, dostrajanie modelu i długi kontekst nie są kolejnymi szczeblami jednej drabiny, tylko narzędziami do różnych problemów. OpenAI w przewodniku „Optimizing LLM accuracy” pisze, że wiele poradników przedstawia je jako prostą ścieżkę: najpierw polecenie, potem RAG, potem dostrajanie. Często tak nie jest — to dźwignie, które rozwiązują różne rzeczy.
Macierz decyzyjna · trzy narzędzia do różnych problemów
| RAG | Dostrajanie modelu | Cała baza wiedzy w poleceniu | |
|---|---|---|---|
| Co rozwiązuje | RAGBrak wiedzy | Dostrajanie modeluZachowanie, styl i format | Cała baza wiedzy w poleceniuBrak wiedzy przy małej bazie, poniżej około 200 tysięcy tokenów według Anthropic z 2024 roku, przy oknie kontekstu do 1 miliona tokenów |
| Aktualizacja wiedzy | RAGWymiana dokumentów | Dostrajanie modeluPonowne trenowanie | Cała baza wiedzy w poleceniuPodmiana treści w poleceniu |
| Źródło w odpowiedzi | RAGTak | Dostrajanie modeluNie | Cała baza wiedzy w poleceniuTak |
| Uprawnienia na użytkownika | RAGFiltr w wyszukiwaniu | Dostrajanie modeluBrak | Cała baza wiedzy w poleceniuPolecenie trzeba składać osobno dla każdej grupy |
| Koszt jednego pytania | RAGNiski | Dostrajanie modeluNiski po treningu | Cała baza wiedzy w poleceniuRośnie z wielkością bazy |
Brakuje wiedzy, więc potrzebny jest kontekst. Gdy model nie zna informacji, bo nie było jej w danych treningowych, jest nieaktualna albo firmowa, trzeba mu ją podać: w poleceniu albo przez RAG. OpenAI dodaje, że wiele jego największych wdrożeń u klientów opierało się wyłącznie na dobrze napisanych poleceniach i RAG.
Zły format, ton albo niespójne rozumowanie, więc potrzebne jest dostrajanie. Dostrajanie (fine-tuning) to dalsze trenowanie modelu na przykładach z Twojej dziedziny. OpenAI zaleca je, gdy model daje niespójne wyniki w złym formacie, pisze niewłaściwym tonem albo nie trzyma się wymaganego sposobu rozumowania. Radzi zaczynać od co najmniej 50 starannie dobranych przykładów, bo jakość danych treningowych liczy się bardziej niż ich liczba. O RAG ten sam przewodnik pisze, że rozwiązuje tylko problemy uczenia się z kontekstu.
RAG dostarcza modelowi wiedzę — fakty, cenniki, procedury — a dostrajanie uczy go zachowania: stylu, tonu i formatu odpowiedzi. Te techniki mogą się uzupełniać. OpenAI pisze, że nakładają się na siebie: gdy pierwsze testy pokazują problemy zarówno z kontekstem, jak i z zachowaniem modelu, w rozwiązaniu produkcyjnym często kończy się na dostrajaniu połączonym z RAG, przy czym RAG wnosi kontekst i aktualniejsze treści. Żadna z tych technik nie gwarantuje odpowiedzi bez błędów.
Mała baza wiedzy, więc cała treść w poleceniu. Czasem RAG nie jest potrzebny. Anthropic pisał we wrześniu 2024 r., że jeśli baza wiedzy ma mniej niż 200 tys. tokenów (według firmy około 500 stron), można ją w całości dołączyć do polecenia, bez RAG. Okna kontekstu, czyli ilość tekstu, którą model przyjmuje w jednym wywołaniu, są dziś większe: dokumentacja Anthropic (odczyt 3.10.2026) podaje do 1 mln tokenów, zależnie od modelu. Ta sama dokumentacja ostrzega jednak, że więcej kontekstu nie znaczy automatycznie lepiej: wraz ze wzrostem liczby tokenów spadają dokładność i zdolność przywoływania informacji. Liczy się więc dobór treści, a nie tylko pojemność. Czym są tokeny i okno kontekstowe i dlaczego dokument wklejany do każdego zapytania mnoży rachunek, wyjaśniamy w artykule o dużych modelach językowych (LLM).
Praktyczna reguła: całą treść dawaj w poleceniu przy małej, rzadko zmienianej bazie i niewielu pytaniach. RAG wybierz przy dużej, często zmienianej bazie, przy różnych uprawnieniach użytkowników i przy dużej liczbie pytań — wtedy różnica w koszcie jest wyraźna, co pokazujemy w rachunku niżej.
Do odpowiadania z dokumentów zwykle nie potrzebujesz też agenta. Anthropic w tekście „Building effective agents” (19.12.2024) pisze, że w wielu zastosowaniach zwykle wystarcza dopracowane pojedyncze wywołanie modelu z wyszukiwaniem i przykładami w poleceniu. Kiedy agent ma sens, a kiedy jest przerostem formy, rozpisujemy w artykule agent AI w firmie.
Co psuje odpowiedzi RAG — pięć przyczyn
Większość złych odpowiedzi RAG zaczyna się przed modelem: w dokumentach i w wyszukiwaniu. OpenAI dzieli błędy na dwa obszary. Wyszukiwanie może podać zły kontekst albo za dużo nieistotnego. Model może dostać właściwy kontekst i zrobić z nim coś złego. Dlatego każdy z tych obszarów testuje się osobno. Pięć najczęstszych przyczyn:
1. Stare dokumenty. Model odpowiada tym, co dostał. Najlepiej pokazuje to eksperyment autorów pracy z 2020 r.: system pytano o 82 przywódców państw, którzy zmienili się między 2016 a 2018 r. Z indeksem Wikipedii z 2016 r. odpowiadał poprawnie w 70% pytań o przywódców z 2016 r., a z indeksem z 2018 r. — w 68% pytań o przywódców z 2018 r. Gdy indeks nie pasował do roku, odsetek poprawnych odpowiedzi spadał do 12% i 4%. To jeden eksperyment badawczy, nie miara skuteczności firmowego RAG, ale zasada jest ogólna: nieaktualny regulamin w bazie da nieaktualną odpowiedź. Baza musi się zmieniać razem z dokumentami. W projekcie naszego czatu każda publikacja i każde usunięcie treści w CMS ma automatycznie aktualizować bazę wiedzy. Wersje robocze trzeba z bazy wykluczyć; OpenAI pokazuje w dokumentacji filtr, który pomija szkice po nazwie pliku.
2. Wyszukiwanie nie trafiło. Fragment wyjęty z dokumentu traci kontekst. Anthropic podaje przykład fragmentu „Przychody firmy wzrosły o 3% w porównaniu z poprzednim kwartałem”, z którego nie wiadomo, o jaką firmę i jaki kwartał chodzi. Do tego dochodzą kody i numery, które wyszukiwanie po znaczeniu gubi. Anthropic opisał technikę dopisywania do każdego fragmentu krótkiego kontekstu z całego dokumentu. W jego testach odsetek nieudanych wyszukiwań spadł o 35%, po połączeniu z wyszukiwaniem po słowach o 49%, a z dodatkowym rerankingiem o 67%. To testy dostawcy na jego zbiorach (kod, literatura, publikacje naukowe), które mierzą, czy właściwy fragment znalazł się wśród 20 najlepszych wyników, a nie to, czy odpowiedź była poprawna.
3. Za dużo albo nie to. Według OpenAI zły kontekst sprawia, że model nie ma szans odpowiedzieć, a za dużo nieistotnego kontekstu zagłusza właściwą informację i powoduje halucynacje. Microsoft w opisie trudności RAG pisze, że system wyszukiwania ma zwracać trafne i zwięzłe wyniki, a nie zrzut całych dokumentów.
4. Sprzeczne źródła. Dwie wersje cennika albo procedura w jednym brzmieniu w dziale sprzedaży i w innym w dziale obsługi. OWASP, projekt społeczności bezpieczeństwa aplikacji, w opisie ryzyka LLM08:2025 wymienia błędy wynikające z tego, że dane z wielu źródeł sobie przeczą. Jeśli dokumenty nie mówią, która wersja obowiązuje, model też tego nie ustali.
5. Zatrute dokumenty i ukryte polecenia. Dokument w bazie może zawierać tekst, który model potraktuje jak polecenie. OWASP opisuje scenariusz CV z ukrytym tekstem, białym na białym tle, w którym kandydat każe zignorować wcześniejsze instrukcje i polecić swoją kandydaturę; system wstępnej selekcji oparty na RAG przetwarza ten tekst razem z resztą CV. To pośrednie wstrzykiwanie poleceń (indirect prompt injection), a OWASP w opisie ryzyka LLM01:2025 pisze, że RAG i dostrajanie nie usuwają w pełni tej podatności. Zalecenie OWASP: sprawdzać każdy dokument, zanim trafi do bazy wiedzy, i używać narzędzi, które wykrywają ukrytą treść. W naszym projekcie treść z bazy wiedzy jest dla modelu danymi, a nie instrukcjami.
Uprawnienia: asystent widzi to, co pozwolisz mu wyszukać
RAG pokaże użytkownikowi wszystko, co znajdzie w indeksie, chyba że uprawnienia filtruje samo wyszukiwanie. W asystentach pakietów biurowych ta zasada jest wbudowana. Microsoft w dokumentacji Copilota (odczyt 3.10.2026) pisze, że Microsoft Copilot pokazuje tylko te dane organizacji, do których użytkownik ma co najmniej prawo podglądu. Google w centrum prywatności Gemini w Workspace (aktualizacja 14.08.2026) zapewnia, że Gemini nie sięga do treści Workspace, do których użytkownik nie ma dostępu. Ryzykiem są tam foldery udostępnione zbyt szeroko — piszemy o tym w części o kosztach przewodnika AI w firmie.
Przy własnym RAG tę zasadę trzeba zbudować. Przykład nasz: firma podłącza do czatu dysk z dokumentami kadrowymi, a system indeksujący czyta pliki z konta technicznego, które widzi wszystko. Na dysku arkusz wynagrodzeń jest dostępny tylko dla kadr, ale w indeksie leży obok regulaminu urlopów. Stażysta pyta czat, ile zarabia jego przełożony, i dostaje odpowiedź z cytatem z arkusza. Nikt niczego nie złamał — wyszukiwanie po prostu nie wiedziało, kto pyta. OWASP opisuje to samo ryzyko ogólnie: przy niewłaściwej kontroli dostępu do embeddingów model może wyszukać i ujawnić dane osobowe, informacje zastrzeżone albo inne wrażliwe treści. W scenariuszu, w którym kilka grup użytkowników korzysta z jednej bazy wektorowej, fragmenty jednej grupy mogą trafić do odpowiedzi dla drugiej.
Microsoft w dokumentacji Azure AI Search ujmuje problem tak: dane finansowe powinny być dostępne tylko dla zespołu finansów, nawet gdy chatbota pyta ktoś z kierownictwa. Rozwiązanie opisuje jako przycinanie wyników na poziomie dokumentu: indeks przejmuje uprawnienia z systemu, w którym leżą pliki, albo wyszukiwanie filtruje wyniki według uprawnień w momencie zapytania. OWASP zaleca bazy wektorowe świadome uprawnień i ścisłe rozdzielenie danych różnych grup użytkowników. W naszym projekcie każde zapytanie do bazy wiedzy przechodzi przez filtr przypisania do firmy (tenanta), zanim cokolwiek trafi do modelu.
Z tego wynikają dwie konsekwencje. Po pierwsze, polecenie dla modelu w rodzaju „nie pokazuj poufnych danych” nie jest zabezpieczeniem. Jeśli fragment z arkuszem trafił już do kontekstu, wszystko zależy od modelu, a według OWASP RAG nie usuwa w pełni podatności na wstrzykiwanie poleceń. Filtr musi zadziałać, zanim fragment trafi do modelu. Po drugie, OWASP ostrzega, że atakujący mogą z embeddingów odtworzyć znaczną część informacji źródłowych. Indeks chronisz więc tak samo jak dokumenty, z których powstał. Kto w firmie powinien mieć dostęp do czego, porządkujemy w tekście o ochronie danych firmy, a pytania do dostawcy chmury zbieramy w artykule o bezpieczeństwie danych w chmurze.
Czy RAG usuwa halucynacje?
Nie. RAG zmniejsza ryzyko, że model coś wymyśli, ale go nie usuwa — tak wynika z dokumentacji samych dostawców modeli. Google: ugruntowanie zmniejsza szanse wymyślania treści. OpenAI w przewodniku o dokładności pisze, że gotowymi metodami modele raczej nie osiągną dokładności 99,999%. Anthropic w dokumentacji „Reduce hallucinations” (odczyt 3.10.2026) wymienia techniki ograniczania halucynacji i zastrzega, że znacząco je ograniczają, ale nie eliminują całkowicie; krytyczne informacje, zwłaszcza przy decyzjach o wysokiej stawce, trzeba sprawdzać.
Te techniki warto wpisać w specyfikację każdego systemu RAG:
- pozwól modelowi powiedzieć „nie wiem” — Anthropic zaleca dać modelowi wprost prawo do przyznania się do niepewności;
- każ odpowiadać wyłącznie z podanych dokumentów, a nie z ogólnej wiedzy modelu;
- wymagaj cytatu przy każdym twierdzeniu, a twierdzenie bez cytatu niech model wycofa;
- przekaż sprawę człowiekowi, gdy w bazie nie ma odpowiedzi. Tak projektujemy nasz czat: brak odpowiedzi w bazie wiedzy albo niska pewność to jeden z warunków przekazania rozmowy pracownikowi.
Ile kontroli potrzebujesz, zależy od kosztu błędu. OpenAI radzi zaczynać każdą rozmowę o dokładności od przybliżonego rachunku, ile kosztuje błąd modelu, a ile przynosi trafna odpowiedź, i podaje przykład różnicy między słabym szkicem tekstu, który człowiek poprawi, a zwrotem dla klienta w wysokości 1 000 $ zamiast 100 $. Asystent, który szuka w dokumentacji technicznej dla zespołu, może się czasem pomylić. Odpowiedź o warunkach umowy dla klienta — już nie bez kontroli. Dlaczego modele w ogóle zmyślają i jak dopasować kontrolę do kosztu błędu, opisujemy w artykule o halucynacjach AI.
Błędna odpowiedź o konkretnej osobie to także sprawa RODO. Europejska Rada Ochrony Danych w raporcie grupy zadaniowej ds. ChatGPT (23.05.2024) zwraca uwagę, że użytkownicy mogą brać odpowiedzi modelu za fakty niezależnie od ich rzeczywistej poprawności, i przypomina, że zasada prawidłowości danych obowiązuje w każdym przypadku. To opis stanowiska, nie porada prawna.
Ile kosztuje RAG
Koszt API w RAG jest mały; płacisz przede wszystkim za przygotowanie dokumentów, uprawnień i testów oraz za utrzymanie. Składniki rachunku za usługi, według cenników z odczytu 3.10.2026:
- embeddingi: w cenniku OpenAI API model text-embedding-3-small kosztuje 0,02 $, a text-embedding-3-large 0,13 $ za milion tokenów; Voyage AI, wskazany w dokumentacji Anthropic, w cenniku podaje za modele z rodziny voyage-4 od 0,02 do 0,12 $ za milion tokenów, z pierwszymi 200 mln tokenów bez opłat dla każdego konta;
- przechowywanie w gotowym narzędziu OpenAI: 1 GB bez opłat, powyżej 0,10 $ za GB dziennie;
- wywołanie gotowego narzędzia file search u OpenAI: 2,50 $ za 1 000 wywołań, czyli około 9,72 zł (nasze przeliczenie);
- tokeny modelu, który pisze odpowiedź — w naszym przykładzie niżej to prawie cały koszt działania.
Policzyliśmy przykład na cenniku Claude API (odczyt 20.10.2026): Claude Sonnet 5.5 kosztuje 2 $ za milion tokenów wejścia, 10 $ za milion tokenów wyjścia i 0,10 $ za milion tokenów odczytanych z pamięci podręcznej (cache), czyli 5% zwykłej ceny wejścia. Dolara przeliczamy po kursie NBP z 2.10.2026: 3,8881 zł. Baza wiedzy to 200 stron po około 800 tokenów — tyle na stronę zakłada OpenAI w dokumentacji embeddingów — razem 160 000 tokenów. Do każdego pytania doliczamy 500 tokenów instrukcji i samego pytania, a odpowiedź ma 300 tokenów. Liczby tokenów to nasze założenia, nie średnia rynkowa.
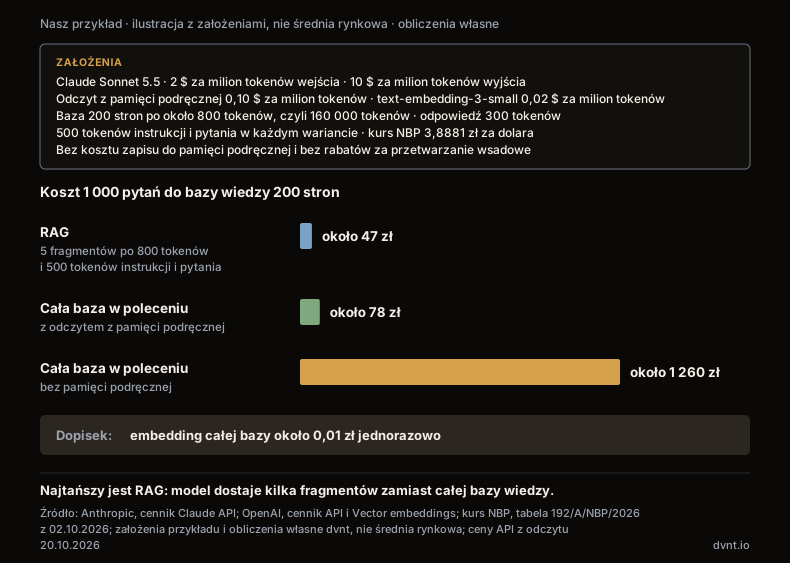
Rachunek krok po kroku (nasza arytmetyka):
- Cała baza w poleceniu, bez pamięci podręcznej: 160 000 tokenów bazy i 500 tokenów instrukcji i pytania, razem 160 500 tokenów × 2 $ za milion = 0,321 $, plus 300 tokenów odpowiedzi × 10 $ za milion = 0,003 $. Razem 0,324 $, czyli około 1,26 zł za pytanie. 1 000 pytań to 1 259,74 zł, około 1 260 zł.
- Cała baza w poleceniu, odczyt z pamięci podręcznej: 160 000 tokenów × 0,10 $ za milion = 0,016 $, plus 500 tokenów instrukcji i pytania po zwykłej cenie (0,001 $) i 0,003 $ za odpowiedź. Razem 0,020 $, około 0,078 zł za pytanie; 1 000 pytań to 77,76 zł, około 78 zł. Ten wariant zakłada, że każde pytanie trafia w pamięć podręczną. Zapis do niej kosztuje osobno: 2,50 $ za milion tokenów przy przechowywaniu przez 5 minut, czyli 0,40 $ (około 1,56 zł) za każde zapisanie całej bazy, a przy rzadkich pytaniach zapis się powtarza.
- RAG: 5 fragmentów po 800 tokenów i 500 tokenów instrukcji i pytania, razem 4 500 tokenów × 2 $ za milion = 0,009 $, plus 0,003 $ za odpowiedź. Razem 0,012 $, około 0,047 zł za pytanie; 1 000 pytań to 46,66 zł, około 47 zł. Embedding samych pytań kosztuje tu ułamki grosza.
- Jednorazowo: embedding całej bazy, 160 000 tokenów × 0,02 $ za milion = 0,0032 $, około 0,01 zł. Przy domyślnej nakładce fragmentów OpenAI liczba tokenów do przeliczenia rośnie mniej więcej dwukrotnie, co nadal daje ułamek grosza.
W tym przykładzie RAG jest około 27 razy tańszy od wysyłania całej bazy bez pamięci podręcznej i około 1,7 raza tańszy od wariantu z pamięcią podręczną. Różnica rośnie razem z bazą: koszt pytania w RAG zależy od liczby wybranych fragmentów, a przy całej bazie w poleceniu — od jej wielkości.
Ważniejsze jest co innego: przy tysiącu pytań rachunek za API w RAG to kilkadziesiąt złotych. Drogie jest to, czego cennik nie pokazuje: uporządkowanie dokumentów, ustawienie uprawnień, zestaw pytań testowych, integracja ze źródłami danych i przegląd odpowiedzi po uruchomieniu. Niezależnego badania cen wdrożeń RAG w Polsce nie znaleźliśmy, więc nie podajemy kwoty z rynku. Jak liczyć koszt tokenów przy agentach, którzy wywołują model wiele razy w jednym zadaniu, pokazujemy w artykule o agencie AI.
Jak zacząć: RAG w firmie w sześciu krokach
Zacznij od jednego pytania biznesowego i jednego zbioru dokumentów, a nie od „całej wiedzy firmy”. Microsoft w przewodniku wdrożenia Copilota (odczyt 3.10.2026) pisze, że asystent daje trafne odpowiedzi wtedy, gdy dane firmy są dobrze zarządzane, aktualne i właściwie udostępnione. To dotyczy każdego RAG. W praktyce to sześć kroków:
- Wybierz jedno zastosowanie i jeden zbiór dokumentów, na przykład procedury obsługi zamówień albo dokumentację oferty. Zapisz, kto będzie pytał i o co.
- Uporządkuj dokumenty. Każdy powinien mieć aktualną wersję, właściciela i datę. Usuń duplikaty i wersje robocze, a sprzeczne wersje rozstrzygnij, zanim trafią do bazy.
- Ustaw uprawnienia przed podłączeniem. W przewodniku Microsoft pierwszym krokiem jest usunięcie nadmiernych udostępnień: znalezienie plików i witryn udostępnionych zbyt szeroko, bez właściciela albo z danymi wrażliwymi, i poprawienie dostępu. Przy własnym RAG zdecyduj, skąd wyszukiwanie weźmie uprawnienia użytkownika.
- Przygotuj zestaw prawdziwych pytań z oczekiwanymi odpowiedziami. Oceniaj osobno, czy wyszukiwanie znalazło właściwy fragment i czy model dobrze go wykorzystał. Anthropic zaleca wprost: zawsze uruchamiaj testy.
- Zdecyduj: gotowe czy własne. Jeśli dokumenty leżą w Microsoft 365 albo Google Workspace, zacznij od asystenta w pakiecie — plany porównujemy w tekście Google Workspace czy Microsoft 365. Własny system ma sens, gdy dane leżą w CMS, ERP i kilku innych źródłach, gdy odpowiedzi mają trafiać do klientów albo gdy potrzebujesz kontroli nad uprawnieniami i kosztem. Przykłady gotowych klocków u dostawców (odczyt 3.10.2026): file search w API OpenAI, czyli narzędzie, którego wyszukiwanie obsługuje sam dostawca; RAG Engine w Google Gemini Enterprise Agent Platform (dawniej Vertex AI), który ma regiony w Europie, choć dokumentacja zaznacza, że rezydencja danych (data residency) nie jest w nim obsługiwana; Azure AI Search u Microsoftu. To przykłady, nie ranking.
- Zaplanuj okres obserwacji. Przeglądaj odpowiedzi „nie wiem” i odpowiedzi błędne, uzupełniaj dokumenty i aktualizuj bazę. Pytania, na które baza nie ma odpowiedzi, pokazują, czego brakuje w dokumentacji firmy.
Tak projektujemy bazę wiedzy czatu AI na digitalvantage.pl. Czat jeszcze nie działa i wyników nie ma, więc opisujemy założenia, nie efekty. Baza obejmuje artykuły, strony i słownik pojęć. Każda publikacja i każde usunięcie treści w CMS ma wysyłać zmianę do bazy, żeby czat nie odpowiadał z wycofanego tekstu. Fragmenty mają około 800 tokenów z nakładką 100. Przy kilku tysiącach fragmentów nie dokładamy osobnej bazy wektorowej: embeddingi będą leżeć w zwykłej bazie danych, a podobieństwo policzy aplikacja; osobna baza wektorowa ma wejść dopiero przy skali rzędu 100 tys. fragmentów. Każde zapytanie przechodzi przez filtr tenanta, treść z bazy jest dla modelu danymi, a nie poleceniami, a odpowiedź zawiera link do źródła, gdy ma to sens. Gdy bazie brakuje odpowiedzi, rozmowę przejmuje człowiek. Po uruchomieniu przez co najmniej cztery tygodnie będziemy co tydzień sprawdzać, gdzie bot zmyślił.
Ten sam mechanizm działa w czacie dla klientów na stronie internetowej, ale tam dochodzi obowiązek informowania rozmówcy, że rozmawia z AI. Kogo obciąża i od kiedy obowiązuje, wyjaśniamy w artykule AI Act dla firmy, a przy chatbotach w sklepach opisujemy go w tekście o obsłudze klienta w e-commerce.
Najczęstsze pytania o RAG
Czym RAG różni się od trenowania (dostrajania) modelu na danych firmy?
RAG podaje modelowi wiedzę w chwili pytania: system wyszukuje fragmenty dokumentów i dołącza je do polecenia. Dostrajanie zmienia sam model przez dalsze trenowanie na przykładach. OpenAI w przewodniku o dokładności modeli rozdziela te zastosowania: brak wiedzy, wiedza nieaktualna albo firmowa to zadanie dla kontekstu, czyli polecenia albo RAG, a zły format, ton i niespójne zachowanie — dla dostrajania. W RAG wiedzę aktualizujesz, wymieniając dokumenty; dostrojony model trzeba trenować ponownie. Obie techniki można łączyć.
Czy do RAG potrzebna jest baza wektorowa?
Nie zawsze. Anthropic pisze, że bazę wiedzy mniejszą niż około 200 tys. tokenów można w całości dołączyć do polecenia, bez RAG. Wyszukiwanie po słowach też jest częścią dobrego RAG, bo wyszukiwanie po znaczeniu gubi kody i numery. W projekcie czatu na naszej stronie przy kilku tysiącach fragmentów embeddingi mają leżeć w zwykłej bazie danych, bez osobnej bazy wektorowej; to założenie projektu, a nie wynik, bo czat jeszcze nie działa.
Czy RAG może pokazać pracownikowi dokument, do którego nie ma dostępu?
Tak, jeśli uprawnień nie filtruje samo wyszukiwanie. System, który indeksuje pliki z konta widzącego wszystko, znajdzie dla każdego to, co leży w indeksie. Microsoft opisuje rozwiązanie jako przycinanie wyników na poziomie dokumentu według uprawnień użytkownika, a OWASP zaleca bazy wektorowe świadome uprawnień. Gotowe asystenty, takie jak Microsoft Copilot i Gemini w Google Workspace, według dokumentacji dostawców pokazują tylko treści, do których użytkownik ma dostęp, więc tam ryzykiem są pliki udostępnione zbyt szeroko.
Kiedy wystarczy wkleić dokumenty do okna kontekstu zamiast budować RAG?
Gdy baza jest mała, rzadko się zmienia, pytań jest niewiele i wszyscy pytający mogą widzieć całą treść. Anthropic podawał w 2024 r. próg około 200 tys. tokenów. Przy dużej liczbie pytań koszt rośnie: w naszym przykładzie 1 000 pytań do bazy 200 stron kosztuje około 1 260 zł bez pamięci podręcznej, około 78 zł z nią i około 47 zł z RAG. Anthropic ostrzega też, że przy bardzo długim kontekście spadają dokładność i zdolność przywoływania informacji.
Czy RAG działa na dokumentach po polsku?
Mechanizm nie zależy od języka, ale jakość wyszukiwania zależy od modelu embeddingów. OpenAI deklaruje lepszą wydajność wielojęzyczną swoich modeli text-embedding-3, a Voyage AI ma w ofercie także model wielojęzyczny. Niezależnej oceny jakości dla języka polskiego nie znaleźliśmy, więc jedyny wiarygodny sprawdzian to Twój własny zestaw prawdziwych pytań z oczekiwanymi odpowiedziami.
Jak często aktualizować bazę wiedzy w RAG?
Przy każdej zmianie dokumentu, najlepiej automatycznie. W eksperymencie autorów pracy o RAG z 2020 r. ten sam system z indeksem z niewłaściwego roku odpowiadał poprawnie w 12% i 4% pytań zamiast w 70% i 68%. Wersje robocze trzymaj poza bazą; OpenAI pokazuje w dokumentacji filtr, który je wyklucza. W projekcie czatu na naszej stronie publikacja i usunięcie treści w CMS mają od razu aktualizować bazę wiedzy; czat jeszcze nie działa.
Powiązane artykuły
Sztuczna inteligencja
Lokalne AI w firmie — własny serwer, chmura w UE czy API? Koszty, prawo i jakość
Lokalne AI w firmie: kiedy własny serwer albo chmura w UE mają sens, ile kosztuje GPU wobec API, co zmienia region UE i które modele open-weight wolno użyć.
Automatyzacja i integracje
API — co to jest? REST API, webhook i OpenAPI wyjaśnione dla firmy
API co to jest: definicja na przykładach NBP, GUS i białej listy VAT, REST API, webhook, OpenAPI, klucze API i bezpieczeństwo integracji.
SaaS i własny produkt
Multi-tenant — co to jest i jak wybrać architekturę SaaS dla wielu klientów
Multi-tenant, czyli wielu klientów w jednej aplikacji: single tenant a multi-tenant, modele silo/pool/bridge, Row Level Security, RODO i wybór modelu dla MVP.
Chmura i bezpieczeństwo
On premise — co to znaczy i kiedy własny serwer w firmie wygrywa z chmurą
On premise, czyli własny serwer w firmie: pełny koszt z amortyzacją i licencjami, koniec wsparcia Windows Server 2016, kiedy wygrywa chmura, a kiedy VPS.
Chmura i bezpieczeństwo
SLA — co to jest i co sprawdzić w umowie SLA z dostawcą chmury
SLA co to jest: ile przestoju mieści się w 99,9%, jak wyglądają SLA AWS, Microsoft i Google, SLO, RPO i RTO oraz 10 rzeczy do sprawdzenia w umowie.
Chmura i bezpieczeństwo
Chmura obliczeniowa — co to jest i czym różnią się IaaS, PaaS i SaaS
Chmura obliczeniowa według definicji NIST: pięć cech, IaaS, PaaS i SaaS, chmura publiczna, prywatna i hybrydowa oraz dane o firmach w Polsce i UE.
Gdzie AI naprawdę się u Was opłaci?
Opowiedzcie, które zadania zabierają Wam dziś najwięcej czasu. Sprawdzimy, czy wystarczy gotowy asystent, czy potrzebne jest wdrożenie na Waszych danych. Jeśli wystarczy ChatGPT w planie firmowym — powiemy to wprost.