
Sztuczna inteligencja18 min czytania3542 słówRedakcja dvnt
Halucynacje AI — dlaczego sztuczna inteligencja zmyśla i jak firma może to wyłapać
Halucynacje AI to pewnie podane, ale fałszywe odpowiedzi modelu. Skąd się biorą, gdzie kosztują firmę i jak ułożyć proces, który je wyłapie przed klientem.
Halucynacje AI to odpowiedzi modelu językowego, które brzmią wiarygodnie i są podane z pewnością siebie, ale są fałszywe: zmyślona data, nieistniejący wyrok, cytat, którego nie ma w dokumencie. OpenAI w tekście „Why language models hallucinate” z 5.09.2025 nazywa je „wiarygodnie brzmiącymi, ale fałszywymi stwierdzeniami”, a amerykański instytut NIST podkreśla, że model podaje takie treści z pewnością siebie. Cytaty ze źródeł anglojęzycznych tłumaczymy sami.
OpenAI w centrum pomocy ChatGPT (odczyt 3.10.2026) wymienia trzy typowe postaci halucynacji: błędne definicje, daty i fakty; zmyślone cytaty, badania i odwołania do nieistniejących źródeł; zbyt pewne odpowiedzi na pytania niejednoznaczne albo złożone. Pada tam też ważne zastrzeżenie: pewność to nie wiarygodność — model może wyrażać dużą pewność także wtedy, gdy się myli.
Dla firmy pytanie nie brzmi więc „czy AI się myli”, bo myli się każdy model. Brzmi: gdzie błąd kosztuje pieniądze albo odpowiedzialność i jak go złapać, zanim trafi do klienta, sądu albo księgowości. Halucynacji nie wyłączysz przełącznikiem. Możesz jednak tak ułożyć pracę, żeby model miał prawo powiedzieć „nie wiem”, odpowiadał ze źródeł, liczby liczyło narzędzie, a człowiek sprawdzał tam, gdzie pomyłka jest droga. Odpowiedzialność za to, co napisze AI, zostaje przy firmie. Źródła odczytaliśmy 3.10.2026.
Halucynacje AI — co to jest (i czym nie są)
Halucynacja to nie tylko fałsz o świecie. To także odpowiedź niezgodna z tekstem, który sam modelowi podałeś. NIST (National Institute of Standards and Technology) w profilu ryzyka dla generatywnej AI (NIST AI 600-1, lipiec 2024) używa terminu konfabulacja i zalicza do niej również wyniki, które odbiegają od polecenia albo innych danych wejściowych, oraz takie, które przeczą temu, co model napisał wcześniej w tej samej rozmowie. W praktyce firma spotyka dwa rodzaje błędu:
- niezgodność z faktami — model podaje nieistniejące orzeczenie, złą datę albo tytuł publikacji, której nikt nie napisał;
- niezgodność z dokumentem — model streszcza umowę, którą mu dałeś, i dopisuje warunek, którego w niej nie ma, albo w trzecim akapicie zaprzecza temu, co napisał w pierwszym.
Drugi rodzaj łatwo przeoczyć, bo intuicja podpowiada, że skoro model „ma dokument”, to się nie pomyli. Ma mniejsze pole do zgadywania, ale nadal może zgadywać.
W źródłach anglojęzycznych zjawisko nazywa się AI hallucination. NIST zaznacza, że „halucynacje” i „fabrykacje” to nazwy potoczne. Po polsku spotkasz też liczbę pojedynczą — halucynacja AI — oraz określenia halucynacje sztucznej inteligencji, halucynacje LLM albo halucynacje modeli językowych. Chodzi o to samo zjawisko.
Czym halucynacje nie są? Nie każdym błędem modelu. OpenAI zauważa, że duże modele rzadko mylą się w pisowni czy w nawiasach, bo te podlegają stałym wzorcom i wraz ze skalą modelu takie błędy znikają. Rzadkich, przypadkowych faktów nie da się natomiast przewidzieć ze wzorców — i stąd biorą się halucynacje. OWASP, projekt społeczności bezpieczeństwa aplikacji, w opisie ryzyka LLM09:2025 dodaje, że halucynacje są głównym, ale nie jedynym źródłem dezinformacji z modeli językowych: dochodzą uprzedzenia wyniesione z danych treningowych i niepełne informacje.
Jak model tworzy tekst token po tokenie i dlaczego czasem wybiera ciąg prawdopodobny, ale nieprawdziwy, wyjaśniamy w artykule o dużych modelach językowych (LLM). Tu idziemy dalej: do tego, które fakty model zmyśla najczęściej i co z tego wynika dla firmy.
Dlaczego AI zmyśla, a nie mówi „nie wiem” (czy AI kłamie?)
AI nie kłamie w ludzkim sensie, bo nie ma zamiaru wprowadzić Cię w błąd. Zgaduje — i jest za zgadywanie nagradzane. Na pytania „dlaczego AI kłamie” albo „czy ChatGPT kłamie” odpowiedź brzmi więc: model nie wie, że nie wie, a nauczono go, że odpowiedź opłaca się bardziej niż milczenie. Najlepiej opisuje to praca naukowa „Why Language Models Hallucinate” (arXiv, 4.09.2025). Trzech z czterech autorów podaje afiliację OpenAI, czwarty Georgia Tech; to preprint, czyli tekst przed recenzją naukową. Wynikają z niej trzy rzeczy ważne dla firmy.
Halucynacja to zwykły błąd klasyfikacji. Autorzy piszą, że halucynacje „nie muszą być tajemnicze”: powstają jako błędy w zadaniu typu „prawda czy fałsz”. Jeśli zdań fałszywych nie da się odróżnić od faktów, halucynacje pojawią się w modelu po wstępnym treningu w wyniku naturalnych presji statystycznych. Co ważne, nawet gdyby dane treningowe były wolne od błędów, cele optymalizowane przy trenowaniu i tak prowadziłyby do błędów. Analiza obejmuje według autorów również modele z rozumowaniem i z wyszukiwaniem.
Model myli się najczęściej przy faktach rzadkich. Według pracy duże modele językowe rzadko mylą się przy faktach często przywoływanych, takich jak data urodzin Einsteina. Mylą się przy tych, które w danych pojawiły się raz albo wcale. Przykład z pracy: model DeepSeek-V3, zapytany w aplikacji 11.05.2025 o datę urodzin jednego z autorów, z wyraźną prośbą, żeby odpowiedział tylko, jeśli ją zna, w trzech próbach podał trzy różne błędne daty. OpenAI na swoim blogu opisuje podobną próbę z tytułem doktoratu tego samego badacza: trzy różne odpowiedzi, żadna poprawna.
Wniosek nasz: fakty Twojej firmy — cena z aktualnego cennika, numer umowy, termin reklamacji, nazwisko klienta, parametr techniczny produktu — to dla modelu fakty rzadkie albo całkiem nieznane. Właśnie tam spodziewaj się zmyśleń, jeśli model ma odpowiadać z pamięci, a nie z dokumentu.
Model jest „zawsze w trybie egzaminu”. Tak autorzy opisują skutek oceniania modeli testami, które karzą niepewność. Blog OpenAI pokazuje to na prostym rachunku: jeśli model zgaduje czyjąś datę urodzin, ma szansę 1 na 365, że trafi, a odpowiedź „nie wiem” gwarantuje zero punktów. Przy tysiącach pytań zgadujący model wypada w rankingach lepiej niż ostrożny. Blef bywa przy tym konkretny: praca podaje przykład „30 września” zamiast „gdzieś jesienią”. Konkret wygląda na wiedzę, choć nią nie jest.
NIST dokłada jeszcze jedno ostrzeżenie, ważne dla każdego, kto sprawdza wyniki AI: model potrafi zmyślić także uzasadnienie albo cytat, które mają wyjaśnić jego odpowiedź, a to dodatkowo skłania ludzi do nadmiernego zaufania. NIST pisze, że modele językowe czasem podają logiczne kroki dojścia do odpowiedzi, choć sama odpowiedź jest błędna. Staranne uzasadnienie nie jest więc dowodem.
Wyższa trafność to nie mniej błędów — test, który to pokazuje
Model, który częściej trafia, może też częściej zmyślać. Pokazuje to test SimpleQA, który OpenAI przytacza w tekście z 5.09.2025. SimpleQA to zestaw krótkich pytań o fakty; dane pochodzą z karty systemowej GPT-5. Odpowiedzi podzielono na trzy grupy: trafne, błędne i takie, w których model nie podał konkretnej odpowiedzi.
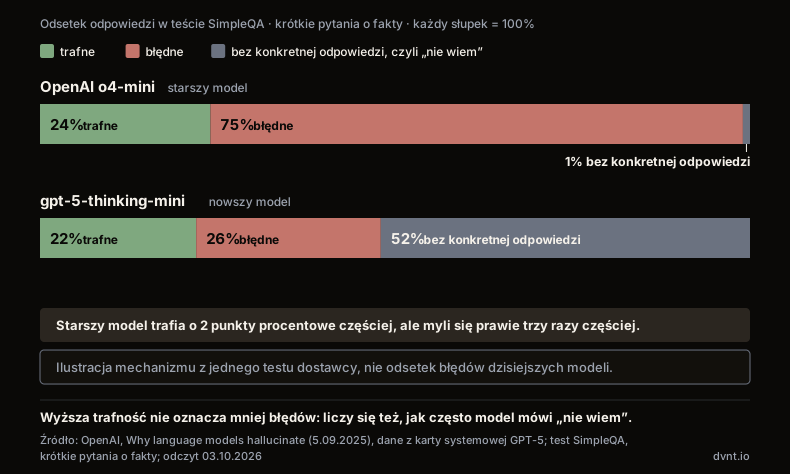
Starszy model o4-mini odpowiedział trafnie na 24% pytań, błędnie na 75%, a tylko w 1% powstrzymał się od odpowiedzi. Model gpt-5-thinking-mini trafił w 22%, pomylił się w 26%, a w 52% nie podał konkretnej odpowiedzi. Trafność różni się o 2 punkty procentowe na korzyść starszego modelu, ale błędnych odpowiedzi ma on prawie trzy razy więcej (75 wobec 26, nasze przeliczenie: około 2,9 raza). OpenAI komentuje, że strategiczne zgadywanie przy niepewności poprawia trafność, ale zwiększa liczbę błędów i halucynacji, a błędy są gorsze niż powstrzymanie się od odpowiedzi.
Zastrzeżenie: to jeden test, dwa modele OpenAI z 2025 r. i dane podane przez samego dostawcę. To ilustracja mechanizmu, nie odsetek błędów dzisiejszych modeli ani Twojego czatu. Ogólnej liczby w rodzaju „AI myli się w X% odpowiedzi” nie podajemy, bo nie znaleźliśmy źródła, które podawałoby ją wiarygodnie.
OpenAI pisze też dwie rzeczy, które łatwo pomylić. W trudniejszych testach i w realnym użyciu trafność nie dojdzie do 100%, bo na niektóre pytania nie da się odpowiedzieć: brakuje informacji, mały model ma ograniczone możliwości albo pytanie jest niejednoznaczne. Halucynacje natomiast nie są nieuniknione, bo model może się wstrzymać, gdy nie jest pewien. Nie jest więc prawdą, że „OpenAI przyznało, że halucynacji nie da się uniknąć” — twierdzi coś odwrotnego.
Przenosząc to na firmę (nasza ocena): jeśli czat albo asystenta oceniasz odsetkiem pytań, na które odpowiedział, nagradzasz zgadywanie tak samo jak rankingi modeli. Licz trzy liczby osobno: odpowiedzi trafne, błędne oraz „nie wiem” przekazane dalej. Błędna odpowiedź to najgorszy wynik; „nie wiem” to koszt obsługi, a nie porażka systemu.
Autorzy pracy proponują, żeby w testach podawać modelowi wprost próg pewności: odpowiadaj tylko wtedy, gdy jesteś pewien powyżej progu t, bo za trafną odpowiedź dostajesz 1 punkt, za „nie wiem” 0, a pomyłka kosztuje t/(1−t) punktu. Przy progu 0,5 pomyłka kosztuje 1 punkt, przy progu 0,9 — 9 punktów. Im wyższy wymagany próg, tym droższa pomyłka w porównaniu z „nie wiem”. Autorzy piszą o ocenianiu modeli; my tę zasadę przenosimy na firmę. Próg możesz zapisać w poleceniu dla modelu i w kryteriach odbioru wdrożenia, wyżej przy cenach i warunkach umów, niżej przy szkicu newslettera.
Gdzie halucynacje kosztują firmę — trzy obszary
Błąd AI kosztuje tam, gdzie ktoś na jego podstawie działa. NIST pisze, że konfabulacje są szczególnie istotne przy otwartych poleceniach o długie odpowiedzi i w dziedzinach wymagających wiedzy specjalistycznej. Szkoda powstaje, gdy użytkownicy uwierzą w fałszywą treść, często z powodu pewnego tonu odpowiedzi, i zaczną na jej podstawie działać albo ją rozpowszechniać. Skali szkód NIST nie szacuje — pisze, że trudno ją ocenić. My też nie podajemy statystyk, bo wiarygodnych nie znaleźliśmy.
Trzy sprawy opisane niżej to orzeczenia z USA, Anglii i Kanady. To nie polskie prawo. Pokazują natomiast, gdzie sądy kładą odpowiedzialność, gdy AI się pomyli.
Pisma, umowy i prawo
Mata v. Avianca (USA, 2023). Sąd federalny dla Południowego Dystryktu Nowego Jorku w postanowieniu o sankcjach z 22.06.2023 (sygn. 22-cv-1461) ustalił, że prawnicy złożyli w sprawie nieistniejące orzeczenia z fałszywymi cytatami, wygenerowane przez ChatGPT, i trwali przy nich także wtedy, gdy sąd zakwestionował ich istnienie. Sąd nałożył karę 5 000 USD solidarnie na dwóch prawników i kancelarię. Najważniejsze jest uzasadnienie: postęp technologiczny jest czymś zwyczajnym i nie ma nic z natury niewłaściwego w korzystaniu z rzetelnego narzędzia AI, ale obowiązujące zasady nakładają na prawników rolę strażnika poprawności ich pism. Sąd wylicza też koszty: strona przeciwna traci czas i pieniądze na wykazanie fałszu, a sąd — czas, który mógłby poświęcić innym sprawom. Sprawę streszcza też załącznik do wyroku londyńskiego opisanego niżej.
Al-Haroun v Qatar National Bank (Anglia, 2025). Wysoki Sąd w Londynie w wyroku z 6.06.2025 ([2025] EWHC 1383 (Admin)) opisał wykaz 45 powołań przedstawionych sądowi. W 18 przypadkach powołane orzeczenie nie istniało. Wśród tych, które istniały, wiele nie zawierało przypisanych im cytatów, nie wspierało tez, na których poparcie je powołano, albo w ogóle nie dotyczyło sprawy.
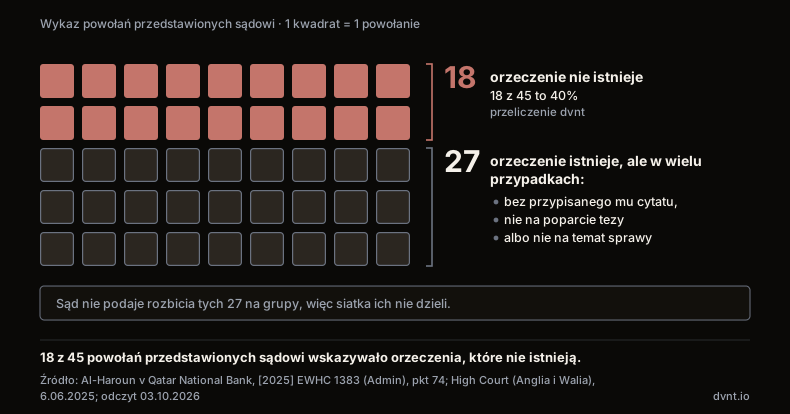
Klient oświadczył, że powołania wygenerował przy użyciu ogólnodostępnych narzędzi AI, prawniczych wyszukiwarek i źródeł internetowych. Jego pełnomocnik oparł się na tych ustaleniach bez samodzielnego sprawdzenia. Sąd stwierdził, że prawnik nie może polegać na kliencie w kwestii poprawności powołań, i skierował sprawę pełnomocnika do regulatora zawodu. W tym samym wyroku sąd rozpatrywał drugą sprawę, Ayinde, w której pismo zawierało pięć fikcyjnych orzeczeń; adwokatka zaprzeczyła, że korzystała z AI, i sąd tego nie przesądził.
Sąd zapisał też zasadę ogólną (pkt 6–8 wyroku): ogólnodostępne narzędzia generatywnej AI, takie jak ChatGPT, nie są w stanie prowadzić rzetelnych badań prawnych. Mogą podawać źródła, które nie istnieją, i cytaty, których w prawdziwym źródle nie ma. Kto ich używa, ma obowiązek sprawdzić wynik w źródłach urzędowych, zanim go wykorzysta, a ta odpowiedzialność nie różni się od odpowiedzialności za pracę aplikanta albo informację z wyszukiwarki.
Krajowa Izba Radców Prawnych w rekomendacjach dotyczących korzystania z AI (2025; prawa autorskie do publikacji ma Microsoft sp. z o.o.) pisze o „pierwszych doniesieniach” o korzystaniu z takich narzędzi bez weryfikacji, w szczególności o wskazywaniu nieistniejących orzeczeń. Polskiego orzeczenia w takiej sprawie nie znaleźliśmy, więc go nie przywołujemy. Dla firmy spoza branży prawniczej lekcja jest ta sama (nasza ocena): umowa, regulamin, pismo do urzędu czy odpowiedź na reklamację przygotowane z pomocą AI są pismami firmy, a nie narzędzia.
Odpowiedzi dla klientów
Moffatt v. Air Canada (Kanada, 2024). Civil Resolution Tribunal, trybunał Kolumbii Brytyjskiej rozpatrujący m.in. drobne roszczenia, w decyzji z 14.02.2024 (2024 BCCRT 149) opisał taką sytuację: klient przed zakupem biletu korzystał z chatbota na stronie Air Canada. Chatbot napisał, że wniosek o obniżoną taryfę z powodu żałoby można złożyć w ciągu 90 dni od wystawienia biletu, także po podróży. Podstrona z zasadami, do której chatbot sam linkował, mówiła, że po zakończeniu podróży taka taryfa nie przysługuje. Przedstawiciel linii przyznał później, że chatbot użył „wprowadzających w błąd słów”.
Air Canada argumentowała, że nie odpowiada za informacje podane przez swoich przedstawicieli, w tym chatbota. Trybunał nazwał to stanowisko „niezwykłym”: chatbot ma element interaktywny, ale nadal jest częścią strony linii, a firma odpowiada za wszystkie informacje na swojej stronie. „Nie ma różnicy, czy informacja pochodzi ze statycznej strony, czy z chatbota”. Trybunał uznał też, że Air Canada nie dołożyła rozsądnej staranności, by chatbot podawał poprawne informacje, i nie wyjaśniła, dlaczego klient miałby sprawdzać informację z jednej części strony w innej. Zasądził 650,88 CAD odszkodowania, razem z odsetkami i opłatami 812,02 CAD.
Zastrzeżenie: Air Canada nie przedstawiła trybunałowi informacji, jak działał jej chatbot, więc nie wiadomo, czy był to model generatywny. Lekcja dotyczy odpowiedzialności, a nie technologii: jeśli narzędzie odpowiada klientom w imieniu firmy, jego odpowiedź jest odpowiedzią firmy. Jak chatboty sprawdzają się w obsłudze klientów sklepów internetowych, opisujemy w tekście o obsłudze klienta w e-commerce. Czat AI dla klientów na stronie firmowej opiszemy w osobnym artykule.
Liczby, dane osobowe i kod
Liczby. OpenAI w centrum pomocy wymienia interpreter kodu i analizę danych jako narzędzia, które umożliwiają dokładne obliczenia. Wniosek nasz: sumy, VAT, przeliczenia walut, rabaty i terminy liczone w dniach roboczych liczy narzędzie albo arkusz, a model najwyżej opisuje wynik słowami. Ten sam rygor dotyczy danych technicznych w treściach sprzedażowych — o tym, gdzie generatywna AI pomaga w opisach produktów, a gdzie trzeba sprawdzić parametry, piszemy osobno.
Dane osobowe. Błędna odpowiedź o konkretnej osobie to sprawa RODO. Europejska Rada Ochrony Danych (EROD) w raporcie o ChatGPT (pkt 30) zauważa, że model z racji swojej probabilistycznej natury może podawać treści zmyślone, a zasada prawidłowości danych i tak musi być przestrzegana. KIRP w rekomendacjach używa pojęcia „ograniczonego zaufania”: dane osobowe wygenerowane przez AI mogą być w części lub w całości „wymyślone”, a to może wpłynąć na każdą decyzję podjętą na ich podstawie. KIRP nazywa też ryzyko nadmiernego polegania na AI, czyli sytuację, w której ktoś polega nadmiernie lub wyłącznie na wynikach wygenerowanych przez narzędzie.
Kod. OWASP w opisie ryzyka LLM09:2025 wymienia sytuację, w której model podsuwa niebezpieczne albo nieistniejące biblioteki programistyczne. W jednym ze scenariuszy atakujący sprawdzają, jakie nazwy paczek asystenci kodowania często zmyślają, i publikują pod tymi nazwami złośliwe paczki w popularnych repozytoriach. Programista, który instaluje zależność zaproponowaną przez AI bez sprawdzenia, sam otwiera drzwi.
Ostrzeżenie „AI może się mylić” nie wystarczy
Dopisek pod czatem to minimum przejrzystości, a nie kontrola błędów. EROD w raporcie grupy zadaniowej ds. ChatGPT (23.05.2024, pkt 31) pisze, że administrator powinien rzetelnie informować o probabilistycznym sposobie tworzenia odpowiedzi i ich ograniczonej wiarygodności, w tym wprost o tym, że wygenerowany tekst, choć poprawny składniowo, może być stronniczy albo zmyślony. Takie informacje pomagają uniknąć błędnej interpretacji, ale nie wystarczają do spełnienia zasady prawidłowości danych.
To wstępne stanowisko grupy zadaniowej wobec jednej usługi, ChatGPT, i jej dostawcy, a nie decyzja skierowana do firm korzystających z AI. Podobny kierunek widać w sprawie Air Canada: trybunał nie oczekiwał od klienta, że sprawdzi odpowiedź chatbota na innej podstronie. Wysoki Sąd w Londynie zauważył z kolei (pkt 82 wyroku), że samo ogłaszanie wytycznych przez samorządy zawodowe nie wystarcza, by przeciwdziałać niewłaściwemu użyciu AI.
Nasz wniosek z tych dwóch źródeł: ostrzeżenie „AI może się mylić” pod czatem nie zdejmuje z firmy odpowiedzialności za to, co jej narzędzie powie klientowi. Jeśli według EROD ostrzeżenie nie wystarcza dostawcy modelu, nie licz, że wystarczy Tobie. EROD pisała o zasadzie prawidłowości danych osobowych, a trybunał w sprawie Air Canada uznał, że firma odpowiada za informacje z chatbota tak samo jak za resztę swojej strony; ostrzeżeń pod czatem ta decyzja nie omawia. To nasze odczytanie opisanych stanowisk, a nie wykładnia polskiego prawa — konkretną sprawę oceni prawnik.
Oznaczenie treści z AI ma sens — OWASP zaleca jasno oznaczać treści generowane przez AI i informować o granicach ich wiarygodności. Ale oznaczenie mówi klientowi, z czym rozmawia, a nie sprawia, że odpowiedź jest poprawna. Tym zajmuje się proces.
Jak zaprojektować proces, który łapie halucynacje — sześć elementów
Kontrolę projektujesz według kosztu błędu, a nie według tego, jak bardzo ufasz modelowi. Anthropic w dokumentacji „Reduce hallucinations” (odczyt 3.10.2026) radzi zawsze sprawdzać krytyczne informacje, zwłaszcza przy decyzjach o wysokiej stawce, a OWASP — automatycznie weryfikować kluczowe wyniki w takich zastosowaniach. Sześć elementów poniżej to praktyczne rozwinięcie tej zasady.
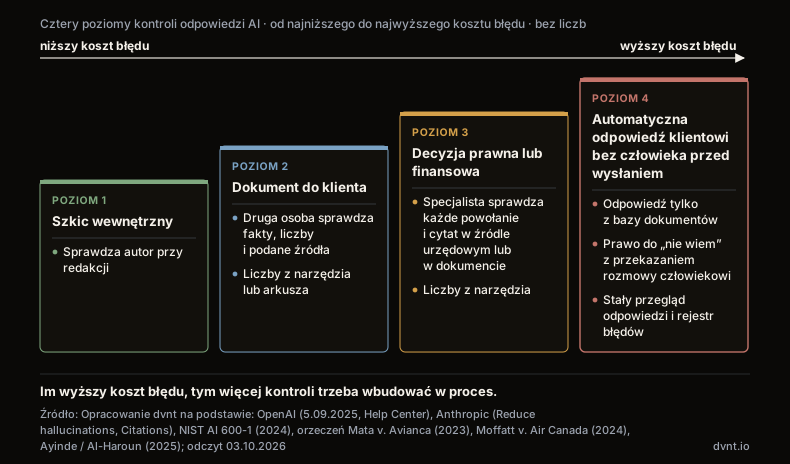
1. Mapa kosztu błędu. Wypisz zastosowania AI w firmie i przy każdym zapytaj: co się stanie, jeśli odpowiedź będzie zmyślona, i kto zauważy to pierwszy. Szkic wewnętrzny poprawi autor. Oferta, umowa czy pismo do urzędu wychodzą na zewnątrz pod nazwą firmy. Decyzja prawna albo finansowa ma skutki, których nie cofniesz poprawką. Najtrudniejsza jest automatyczna odpowiedź klientowi, bo przed jej wysłaniem nikt jej nie czyta — kontrola musi być wbudowana w projekt, a nie dopisana na końcu.
2. Źródła zamiast pamięci modelu. Jeśli model ma podać fakt o Twojej firmie, daj mu dokument, z którego ma go wziąć. Google w opisie groundingu (aktualizacja 1.10.2026) definiuje grounding AI (ugruntowanie) jako zdolność łączenia odpowiedzi modelu ze sprawdzalnymi źródłami informacji, która zmniejsza szanse wymyślania treści. Jak zbudować odpowiadanie z dokumentów firmy i co je psuje, opisujemy w artykule o RAG.
3. Cytat sprawdzany, a nie tylko podany. NIST zaleca przeglądać i weryfikować źródła i cytaty w wynikach generatywnej AI, zarówno przed wdrożeniem, jak i w stałym monitoringu (działanie MS-2.5-003). To jest właściwy fact checking AI: otwórz źródło i znajdź w nim zdanie, na które powołuje się model. Uwaga na pułapkę. Anthropic w dokumentacji funkcji Citations gwarantuje, że zwrócony cytat zawiera poprawny wskaźnik do podanego dokumentu. To gwarancja, że fragment istnieje, a nie że teza jest prawdziwa ani że fragment ją popiera. W sprawie Al-Haroun część orzeczeń istniała, tylko nie było w nich przypisanych im cytatów albo nie dotyczyły sprawy.
4. Prawo do „nie wiem” i przekazanie człowiekowi. Model, który może odmówić, zgaduje rzadziej — to lekcja z testu SimpleQA. W poleceniu daj mu wprost prawo do odpowiedzi „nie wiem” i określ próg pewności odpowiedni do kosztu błędu. Odpowiedź „nie wiem” musi jednak gdzieś prowadzić: do pracownika, formularza albo kolejki zgłoszeń. Tak projektujemy czat AI na naszej stronie: brak odpowiedzi w bazie wiedzy albo niska pewność ma oznaczać przekazanie rozmowy pracownikowi, a nie zgadywanie. Czat jeszcze nie działa i wyników nie ma, więc opisujemy założenie, nie efekt.
5. Liczby przez narzędzie, spójność przez porównanie. Obliczenia zlecaj narzędziu (interpreter kodu, arkusz, system księgowy), a nie modelowi piszącemu tekst. Do wyłapywania zmyśleń Anthropic opisuje trzy techniki porównywania i ponownego sprawdzania wyników. Weryfikacja Best-of-N: to samo polecenie uruchamiasz kilka razy i porównujesz wyniki — rozbieżności mogą wskazywać na halucynację, co dobrze pasuje do wniosku o rzadkich faktach (DeepSeek-V3 podał trzy różne daty w trzech próbach). Przegląd rozumowania: gdy odpowiedź wygląda podejrzanie, czytasz streszczenie toku rozumowania modelu, które może ujawnić błędną logikę lub założenia. Iteracyjne doprecyzowanie: wynik modelu trafia do kolejnego polecenia z prośbą o weryfikację wcześniejszych twierdzeń. Przy przeglądzie rozumowania pamiętaj o zastrzeżeniu NIST: uzasadnienie też bywa zmyślone.
6. Recenzent, który umie sprawdzać, i rejestr błędów. Najsłabszym ogniwem bywa człowiek, który ma sprawdzać, a zatwierdza. NIST opisuje to zjawisko jako automation bias, czyli skłonność do nadmiernego zaufania systemom automatycznym, i pisze, że może ono wzmacniać ryzyko konfabulacji. OWASP zaleca, by recenzenci byli odpowiednio przeszkoleni, właśnie po to, żeby nie polegali nadmiernie na treściach z AI. Komisja Europejska w pytaniach i odpowiedziach o kompetencjach w zakresie AI (aktualizacja 27.07.2026) pisze, że pracownicy i osoba pełniąca rolę człowieka w pętli potrzebują umiejętności dopasowanych do systemu, którego używają. Po wdrożeniu NIST zaleca procesy monitorowania pod kątem konfabulacji (działanie MG-4.1-002). W małej firmie wystarczy prosty rejestr (nasz przykład, bez liczb): pytanie, odpowiedź modelu, na czym polegał błąd, kto go wychwycił, co poprawiono w dokumentach albo w poleceniu.
Im więcej kroków model wykonuje bez kontroli, tym więcej miejsc, w których błąd może przejść dalej (nasza ocena). Dotyczy to zwłaszcza agenta AI, który sam wybiera narzędzia i wykonuje kolejne działania, ale też automatyzacji, w których model jest jednym z kroków, na przykład w n8n, oraz narzędzi podłączanych do modelu przez MCP. Jak projektować zatwierdzenia w agencie, opisujemy w poradniku jak zbudować agenta AI.
Czego nie obiecywać: techniki zmniejszają, nie usuwają
Żadna technika nie sprowadza halucynacji do zera i nikt, kto obiecuje inaczej, nie opiera się na dokumentacji dostawców. Anthropic pisze, że opisane techniki znacząco ograniczają halucynacje, ale ich nie eliminują całkowicie. Google — że ugruntowanie zmniejsza szanse wymyślania treści. OpenAI — że trafność nie dojdzie do 100%. Dostawcy nie podają przy tym procentów skuteczności poszczególnych technik, więc i my ich nie podajemy. Ostrożnie z obietnicami, że rozwiąże to nowszy model, dłuższe polecenie albo „dobry prompt”: każde z tych działań może zmniejszyć liczbę błędów, żadne jej nie wyzeruje.
Z mapy kosztu błędu wynika też granica (nasza ocena): tam, gdzie jedna pomyłka kosztuje więcej niż ręczne wykonanie pracy, AI nie powinno działać bez człowieka. Może przygotować szkic, wyszukać dokumenty albo wskazać miejsca do sprawdzenia, ale decyzję podejmuje i podpisuje osoba, która ją sprawdziła. Zasady korzystania z asystentów AI przez pracowników, w tym sprawdzanie wyniku przed wysłaniem, opisujemy w porównaniu ChatGPT, Copilota i Gemini dla firm.
Halucynacje a AI Act i RODO — krótko
AI Act nie wyznacza poziomu wiedzy o halucynacjach, ale Komisja Europejska oczekuje, że pracownicy będą znać to ryzyko. KE w tych samych pytaniach i odpowiedziach o art. 4 AI Act pisze, że firma, której pracownicy używają ChatGPT na przykład do pisania tekstów reklamowych albo tłumaczeń, powinna ich poinformować o konkretnych ryzykach, „na przykład halucynacjach”. Według KE art. 4 nie wymaga zagwarantowania określonego poziomu tej wiedzy ani jej mierzenia. Kogo i od kiedy obowiązuje art. 4, wyjaśniamy w artykule AI Act dla firmy.
RODO dotyczy halucynacji wtedy, gdy model zmyśla coś o konkretnej osobie: zasada prawidłowości danych obowiązuje, a ostrzeżenie o możliwych błędach jej nie spełnia, jak opisaliśmy wyżej. To opis stanowisk, nie porada prawna. Szerszy obraz tego, od czego zacząć z AI w firmie, znajdziesz w przewodniku AI w firmie.
Najczęstsze pytania o halucynacje AI
Czy ChatGPT kłamie?
Nie w sensie zamiaru. ChatGPT, jak każdy model językowy, czasem zgaduje i podaje zgadywaną odpowiedź z pewnością siebie. OpenAI wyjaśnia, że standardowe trenowanie i ocenianie modeli nagradza zgadywanie bardziej niż przyznanie się do niepewności, a w centrum pomocy ostrzega, że pewność to nie wiarygodność. Efekt dla Ciebie jest jednak podobny jak przy kłamstwie: dostajesz nieprawdę podaną przekonująco, więc ważne informacje sprawdzaj w źródle.
Czy nowszy lub płatny model przestaje halucynować?
Może halucynować rzadziej, ale nie przestaje. OpenAI pisze, że halucynacje zdarzają się także w ChatGPT i pozostają podstawowym wyzwaniem dla wszystkich dużych modeli językowych, a trafność nie dojdzie do 100%. Anthropic zastrzega, że techniki ograniczania halucynacji ich nie eliminują. Test SimpleQA pokazuje też, że model o wyższej trafności może mylić się częściej, jeśli zgaduje zamiast powiedzieć „nie wiem”. Rankingów modeli „który halucynuje najmniej” nie publikujemy, bo nie znaleźliśmy wiarygodnych pomiarów dla zastosowań firmowych.
Czy wystarczy dopisać pod czatem „AI może się mylić”?
Nie. Europejska Rada Ochrony Danych w raporcie o ChatGPT (pkt 31) pisze, że informacja o tym, że tekst może być zmyślony, pomaga uniknąć błędnej interpretacji, ale nie wystarcza do spełnienia zasady prawidłowości danych. W sprawie Moffatt v. Air Canada trybunał uznał, że firma odpowiada za informacje z chatbota tak jak za resztę strony, i nie oczekiwał od klienta, że sprawdzi je gdzie indziej. Oznaczenie treści z AI warto mieć, ale kontrolę błędów zapewnia dopiero proces.
Kto odpowiada, gdy chatbot firmy poda klientowi błędną informację?
W sprawie Moffatt v. Air Canada (Kolumbia Brytyjska, 2024) — firma: trybunał uznał, że chatbot jest częścią strony linii, a linia odpowiada za wszystkie informacje na niej, i zasądził 812,02 CAD łącznie z odsetkami i opłatami. To kanadyjskie orzeczenie, nie polskie prawo; pokazuje kierunek, a nie rozstrzyga sprawy w Polsce. Jak odpowiedzialność wyglądałaby w konkretnym przypadku według polskich przepisów, oceni prawnik.
Jak szybko sprawdzić, czy źródło podane przez AI istnieje?
Otwórz link samodzielnie, zamiast ufać opisowi — OpenAI radzi sprawdzać źródła, wchodząc bezpośrednio na podane strony. Znajdź w dokumencie zdanie, które model cytuje; samo istnienie dokumentu nie wystarcza, bo w sprawie Al-Haroun część orzeczeń istniała, ale nie zawierała przypisanych im cytatów. Przy przepisach i orzeczeniach sięgaj do źródeł urzędowych, czego od prawników wymaga londyński sąd. Nawet funkcja cytowania w API gwarantuje tylko, że fragment pochodzi z dokumentu, a nie że potwierdza tezę.
Czy halucynacje dotyczą też AI, które odpowiada z dokumentów firmy?
Tak, choć zwykle rzadziej. NIST zalicza do konfabulacji także odpowiedzi, które odbiegają od danych wejściowych, czyli od dokumentów podanych modelowi. Google pisze, że ugruntowanie w źródłach zmniejsza szanse wymyślania treści, a Anthropic, że techniki ograniczania halucynacji, w tym odpowiadanie wyłącznie z podanych dokumentów, ich nie eliminują. Dlatego także system odpowiadający z dokumentów potrzebuje sprawdzania cytatów, prawa do „nie wiem” i przeglądu odpowiedzi.
Powiązane artykuły
Sztuczna inteligencja
Jak stworzyć agenta AI w firmie — od procesu do pierwszej działającej wersji
Jak stworzyć agenta AI w firmie krok po kroku: proces, narzędzia i uprawnienia, człowiek w pętli, limity kosztu, testy i ochrona przed prompt injection.
Sztuczna inteligencja
RAG AI — jak sztuczna inteligencja odpowiada na podstawie dokumentów firmy
RAG AI to sposób, w jaki model językowy odpowiada na podstawie dokumentów firmy. Jak działa, co psuje odpowiedzi, ile kosztuje i jak zacząć bez ryzyka.
Automatyzacja i integracje
n8n — co to jest i kiedy ma sens w firmie
n8n co to jest? Narzędzie do automatyzacji z węzłami AI, w chmurze lub na własnym serwerze. Licencja, ceny, bezpieczeństwo i porównanie z Make i Zapier.
Sztuczna inteligencja
LLM — co to jest duży model językowy i co musi o nim wiedzieć firma
LLM to duży model językowy, który pisze tekst token po tokenie. Skąd biorą się jego błędy, co to okno kontekstowe, za co płacisz i kiedy model lokalny.
Sztuczna inteligencja
MCP (Model Context Protocol) — co to jest i co daje firmie
Model Context Protocol (MCP) łączy asystentów i agentów AI z systemami firmy. Jak działa serwer MCP, co daje, jakie ma ryzyka i kiedy warto go budować.
Sztuczna inteligencja
ChatGPT Business, Copilot czy Gemini dla firmy — plany, ceny i dane
ChatGPT Business, Copilot czy Gemini dla firmy: co zmienia plan firmowy, ile kosztuje użytkownik, umowa powierzenia i co masz już w pakiecie biurowym.
Gdzie AI naprawdę się u Was opłaci?
Opowiedzcie, które zadania zabierają Wam dziś najwięcej czasu. Sprawdzimy, czy wystarczy gotowy asystent, czy potrzebne jest wdrożenie na Waszych danych. Jeśli wystarczy ChatGPT w planie firmowym — powiemy to wprost.