
Sztuczna inteligencja22 min czytania4208 słówRedakcja dvnt
LLM — co to jest duży model językowy i co musi o nim wiedzieć firma
LLM to duży model językowy, który pisze tekst token po tokenie. Skąd biorą się jego błędy, co to okno kontekstowe, za co płacisz i kiedy model lokalny.
LLM (large language model), czyli duży model językowy, to program wytrenowany na ogromnej ilości tekstu, który przewiduje kolejny fragment tekstu i w ten sposób, kawałek po kawałku, pisze odpowiedź. Na takich modelach działają ChatGPT, Claude, Gemini i Copilot. Anthropic, twórca modeli Claude, opisuje w słowniczku swojej dokumentacji LLM jako modele językowe z wieloma parametrami, trenowane na ogromnych zbiorach tekstu, które potrafią pisać tekst podobny do ludzkiego, odpowiadać na pytania i streszczać informacje. Cytaty z angielskich źródeł w tym tekście tłumaczymy sami.
Osobnej kategorii dla LLM w badaniu GUS nie ma. Najbliższa jest, w naszej ocenie, kategoria „technologie generujące tekst lub głos”. Według publikacji GUS „Społeczeństwo informacyjne w Polsce w 2025 r.” korzystało z nich 5,3% przedsiębiorstw z co najmniej 10 pracującymi, a z jakiejkolwiek technologii AI 8,7%. Był to najczęściej stosowany rodzaj AI.
Z jednego mechanizmu, przewidywania kolejnego fragmentu tekstu, wynikają cztery rzeczy, które warto rozumieć przed decyzją o wdrożeniu. Model myli się pewnym tonem i nie da się tego wyłączyć. Pamięta tylko to, co mieści się w oknie kontekstowym i co wysyłasz mu za każdym razem od nowa. Płacisz od liczby tokenów, a w naszym pomiarze polski tekst miał ich wyraźnie więcej niż ten sam tekst po angielsku. O danych decyduje to, czy korzystasz z aplikacji, z API, czy z modelu na własnym serwerze. Nazwy modeli, ceny i przepisy podajemy według stanu na 3.10.2026.
LLM — co to jest duży model językowy
Duży model językowy to model statystyczny, który ocenia, jaki fragment tekstu najprawdopodobniej pojawi się dalej. „Duży” odnosi się do liczby parametrów, czyli liczb ustalanych w trakcie trenowania. Google w kursie Machine Learning Crash Course definiuje model językowy jako model, który szacuje prawdopodobieństwo wystąpienia tokenu albo ciągu tokenów w dłuższym ciągu. Duże modele językowe według Google przewidują ciągi tokenów i przewyższają wcześniejsze modele dzięki ogromnej liczbie parametrów i szerszemu kontekstowi, który biorą pod uwagę.
Prawo słowa „LLM” nie używa. AI Act w motywie 99 nazywa „duże generatywne modele AI” typowym przykładem modelu AI ogólnego przeznaczenia. W motywie 98 dodaje, że modele „o co najmniej miliardzie parametrów” trenowane na dużej ilości danych „są bardzo ogólne”. To wskazówka z motywu, a nie próg prawny ani definicja dużego modelu.
Model powstaje w trzech etapach, które Anthropic opisuje w tym samym słowniczku:
- Trenowanie wstępne. Model uczy się na ogromnym zbiorze tekstu przewidywać następne słowo na podstawie wcześniejszego kontekstu. Po tym etapie, jak pisze Anthropic, model nie jest jeszcze dobry w odpowiadaniu na pytania ani w wykonywaniu poleceń.
- Dostrajanie (fine-tuning). Dalsze trenowanie na dodatkowych danych.
- RLHF (reinforcement learning from human feedback), czyli uczenie ze wzmocnieniem na podstawie ocen ludzi. Ten etap i dostrajanie robią z modelu, który dopełnia tekst, model przydatny w pracy.
Model to nie aplikacja. ChatGPT, Claude czy Gemini w przeglądarce to aplikacje z interfejsem, historią rozmów i dodatkowymi funkcjami. Pod spodem działa model, a te same modele dostawcy udostępniają programistom przez API. Anthropic pisze wprost, że asystent Claude jest oparty na dużym modelu językowym. Za aplikację i za API płacisz inaczej i na innych warunkach ochrony danych — o tym niżej.
„Large language model”, „LLM”, „duży model językowy”, „modele LLM” i potocznie „model językowy” to w praktyce ta sama kategoria. Model językowy nie musi być duży, ale w rozmowach o AI w firmie prawie zawsze chodzi o duży.
Jak działa LLM: odpowiedź powstaje token po tokenie
Tak samo działa ChatGPT i każdy inny czat AI: model dostaje tekst, wylicza prawdopodobieństwa możliwych kolejnych fragmentów, wybiera jeden, dokleja go do odpowiedzi i powtarza ten krok aż do końca. Tym fragmentem jest token.
Token to najmniejsza jednostka, w której model przetwarza tekst. Według Anthropic może odpowiadać słowu, części słowa, pojedynczemu znakowi, a nawet bajtowi. Google podaje przykład: tokenem może być pojedyncza litera „z” albo całe słowo „cat”, a długie słowa są dzielone na kilka tokenów. Dostawcy podają przeliczniki, ale każdy dotyczy języka angielskiego:
- Anthropic: liczba znaków na token zależy od modelu i języka. We wcześniejszych modelach Claude token to około 3,5 znaku tekstu angielskiego, a modele od Claude 4.7 używają nowszego tokenizera, który dla tego samego tekstu daje około 30% więcej tokenów (Glossary, odczyt 20.10.2026).
- OpenAI: token to około 4 znaki albo trzy czwarte słowa, a 100 tokenów to około 75 słów. OpenAI dodaje, że to szacunki, a w innych językach proporcje między znakami, słowami i tokenami mogą być inne (Understanding and counting tokens).
- Google: token w modelach Gemini to około 4 znaki, a 100 tokenów to około 60–80 słów angielskich (Understand and count tokens).
Google tłumaczy mechanizm tak: pytanie zadane modelowi można traktować jak zdanie, po którym stoi wyobrażona „maska”, a model generuje prawdopodobieństwa różnych możliwych odpowiedzi w jej miejscu. Wybrany fragment staje się częścią tekstu, a na wydłużonym tekście model liczy kolejne prawdopodobieństwa. Tak powstaje każde zdanie odpowiedzi.
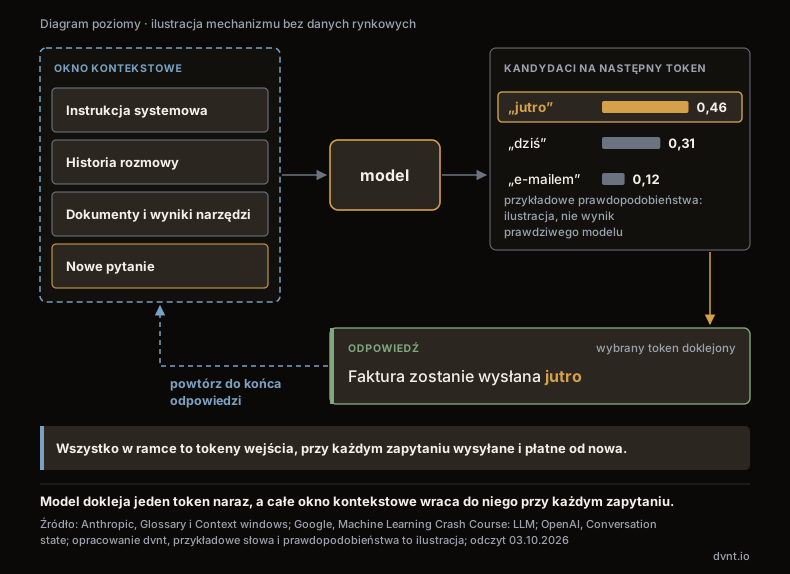
Z tego mechanizmu wynika ograniczenie, które Google nazywa wprost: model wytrenowany na ogromnej liczbie zadań tekstowych z matematyki może sprawiać wrażenie, że rozumuje, ale „w zasadzie dopełnia” treść zadania. Nasz wniosek: rachunki, daty i kwoty niech liczy zwykły program, a model najwyżej przygotowuje do nich dane.
Ta sama prośba nie zawsze daje tę samą odpowiedź. Losowością wyboru kolejnego tokenu steruje parametr zwany temperaturą. Niższa temperatura daje według Anthropic wyniki bardziej zachowawcze i przewidywalne. Anthropic zastrzega jednak, że nawet przy temperaturze 0 wyniki nie są w pełni deterministyczne, a identyczne zapytania mogą dać różne odpowiedzi. Nasz wniosek dla wdrożeń: model sprawdzasz na wielu próbach tego samego zadania, a nie na jednej udanej rozmowie.
Ile tokenów ma polski tekst — nasz pomiar
Żaden z trzech dostawców nie podaje przelicznika dla polskiego, więc sprawdziliśmy to sami na jednym tekście: motywach 97–99 AI Act w oficjalnej wersji polskiej i angielskiej. Polska wersja ma 3 377 znaków i 465 słów, angielska 3 075 znaków i 492 słowa. Tokeny policzyliśmy 3.10.2026 biblioteką tiktoken w wersji 0.14.0, którą OpenAI poleca do programowego liczenia tokenów, w dwóch kodowaniach. Biblioteka przypisuje kodowanie o200k_base między innymi modelom GPT-4o i GPT-5, a cl100k_base modelom GPT-4 i GPT-3.5.
Kodowanie | Tokeny PL | Tokeny EN | PL / EN | Znaków na token PL / EN | Tokenów na słowo PL / EN |
|---|---|---|---|---|---|
o200k_base | 942 | 564 | 1,67 | 3,6 / 5,5 | 2,03 / 1,15 |
cl100k_base | 1 133 | 566 | 2,00 | 3,0 / 5,4 | 2,44 / 1,15 |
W naszym pomiarze polska wersja tego samego tekstu miała 1,67 raza więcej tokenów w nowszym kodowaniu i 2,00 raza więcej w starszym. Dla kontroli policzyliśmy też cały art. 53 AI Act: wyszło około 1,6 i 1,9 raza (dokładny wynik zależy o kilka setnych od tego, jak wyciągnie się tekst ze strony). Kierunek się nie zmienia, ale wielkość zależy od tekstu. Angielski tekst prawny dał przy tym około 5,5 znaku na token, wyraźnie więcej niż ogólne „około 4 znaki” z pomocy OpenAI. Takie przeliczniki są bardzo zgrubne.
Zastrzeżenia: to jeden tekst prawny plus jeden kontrolny i dwa kodowania OpenAI. Biblioteka w tej wersji nie wskazuje kodowania dla obecnych modeli GPT-6. Claude i Gemini mają własne tokenizery, a Anthropic pisze, że modele Claude od wersji 4.7 liczą ten sam tekst na około 30% więcej tokenów niż starsze. Wniosek praktyczny: zanim policzysz koszt albo zmieścisz dokumenty w oknie kontekstowym, przepuść próbkę własnych polskich tekstów przez licznik dostawcy, którego zamierzasz używać. U Anthropic liczenie tokenów jest bezpłatne i liczy dla wskazanego modelu.
Dlaczego LLM się myli — i czemu nie da się tego wyłączyć
Model, który przewiduje prawdopodobny ciąg dalszy tekstu, czasem wybierze ciąg prawdopodobny, ale nieprawdziwy. To nie usterka konkretnego produktu, tylko cecha tej technologii. Amerykański instytut NIST (National Institute of Standards and Technology) w profilu ryzyka dla generatywnej AI (NIST AI 600-1, lipiec 2024) nazywa to konfabulacją, potocznie halucynacją: wytwarzaniem treści podanych z pewnością siebie, ale błędnych lub fałszywych. Według NIST konfabulacje są „naturalnym skutkiem” tego, jak zaprojektowane są modele generatywne: ich wyniki przybliżają rozkład statystyczny danych treningowych. Taka predykcja może dać wynik zgodny z faktami, ale też błędny albo wewnętrznie sprzeczny.
OpenAI w tekście „Why language models hallucinate” z 5.09.2025 definiuje halucynacje jako „wiarygodnie brzmiące, ale fałszywe stwierdzenia” i podaje dwie przyczyny:
- Trenowanie nie zna prawdy i fałszu. W trenowaniu wstępnym model uczy się przewidywać następne słowo w ogromnych ilościach tekstu, a do zdań nie są dołączone etykiety „prawda” i „fałsz”.
- Oceny nagradzają zgadywanie. Standardowe procedury trenowania i oceniania modeli nagradzają zgadywanie bardziej niż przyznanie się do niepewności. Gdy liczy się tylko odsetek trafnych odpowiedzi, model jest zachęcany do zgadywania zamiast odpowiedzi „nie wiem”.
OpenAI dodaje, że w trudniejszych testach i w realnym użyciu trafność zostaje „poniżej 100%”, bo na niektóre pytania nie da się odpowiedzieć: brakuje informacji, mały model ma ograniczone możliwości albo pytanie jest niejednoznaczne.
Model ma datę ważności wiedzy. Wie tylko to, co było w danych treningowych, a o późniejszych wydarzeniach nie wie nic, dopóki mu ich nie podasz. Anthropic podaje dla każdego modelu „reliable knowledge cutoff”, czyli datę, do której wiedza modelu jest wiarygodna, i osobno datę odcięcia danych treningowych. Według przeglądu modeli Anthropic obie daty dla czterech obecnych modeli Claude, w tym Claude Sonnet 5.5, to czerwiec 2026 r. (odczyt 20.10.2026). OpenAI podaje dla GPT-6.1 Sol datę 30.04.2026 (Models, odczyt 3.10.2026). Te daty zmieniają się z każdą nową wersją modelu.
Błąd modelu nie zwalnia z RODO. Europejska Rada Ochrony Danych w raporcie grupy zadaniowej ds. ChatGPT (23.05.2024) zwraca uwagę, że użytkownicy prawdopodobnie biorą odpowiedzi ChatGPT za zgodne z faktami, również informacje o konkretnych osobach, niezależnie od ich rzeczywistej poprawności. Zasada prawidłowości danych obowiązuje mimo to.
Co pomaga, choć niczego nie gwarantuje? Anthropic w poradniku „Reduce hallucinations” radzi dwie proste rzeczy: wprost pozwolić modelowi odpowiedzieć „nie wiem” oraz przy długich dokumentach (powyżej 20 000 tokenów) kazać mu najpierw wypisać dosłowne cytaty, a dopiero potem wykonać zadanie. Naszym zdaniem najwięcej daje jednak organizacja pracy: model dostaje źródła, na których ma się opierać, a człowiek sprawdza wynik, zanim trafi do klienta. Skąd biorą się zmyślenia, gdzie najwięcej kosztują firmę i jak ułożyć proces, który je wyłapie, opisujemy w artykule o halucynacjach AI.
Okno kontekstowe — „pamięć robocza” modelu
Okno kontekstowe to cały tekst, który model może wziąć pod uwagę przy pisaniu odpowiedzi. Poza nim model ma tylko wiedzę z trenowania: nie pamięta poprzednich rozmów ani niczego, czego mu nie wysłałeś. Anthropic w słowniczku nazywa okno kontekstowe „pamięcią roboczą” modelu i odróżnia je od ogromnego zbioru danych, na którym model był trenowany. Google w dokumentacji długiego kontekstu porównuje je do pamięci krótkotrwałej: zmieści się w niej ograniczona ilość informacji.
W oknie mieści się wszystko, co składa się na jedno zapytanie. Według Anthropic (Context windows) liczy się instrukcja systemowa, każda wiadomość z historii rozmowy razem z wynikami narzędzi, obrazami i dokumentami, definicje narzędzi oraz sama odpowiedź, którą model generuje.
Rozmiary okien: wszystkie cztery obecne modele Claude, od Claude Haiku 5.5 do Claude Fable 5.1, mają 1 mln tokenów (odczyt 20.10.2026), GPT-6.1 Sol — 1,05 mln (3.10.2026). Google pisze, że wiele modeli Gemini ma okno 1 mln tokenów lub większe, i podaje skalę: milion tokenów to na przykład 50 000 linii kodu albo 8 powieści średniej długości. Chodzi o powieści po angielsku; w naszym pomiarze polski tekst zajmował wyraźnie więcej tokenów.
Model nie pamięta rozmowy. W dokumentacji API OpenAI pisze, że każde zapytanie o wygenerowanie tekstu jest niezależne i bezstanowe. Rozmowę prowadzi się tak, że przy każdym zapytaniu wysyła się modelowi dotychczasową historię. Nawet gdy korzystasz z funkcji, która wiąże kolejne odpowiedzi po stronie OpenAI, wszystkie wcześniejsze tokeny wejścia są rozliczane jako tokeny wejścia przy każdym kolejnym zapytaniu. Dopóki historia rośnie, każda kolejna wymiana kosztuje więc więcej niż poprzednia.
Aplikacje czatu radzą sobie z długimi rozmowami po swojemu. Anthropic zaznacza, że interfejsy takie jak claude.ai mogą zarządzać oknem na zasadzie „pierwsze weszło, pierwsze wychodzi”, czyli usuwać najstarsze wiadomości. Jeśli w długiej rozmowie model „zapomniał” ustalenia z początku, jedna z możliwych przyczyn jest prosta: ta wiadomość wypadła z okna. W API przekroczenie okna grozi, jak ostrzega OpenAI, uciętą odpowiedzią.
Większe okno nie znaczy lepiej. Według Anthropic wraz ze wzrostem liczby tokenów spada trafność i zdolność odnajdywania informacji; zjawisko nazywa „context rot”. Dobór tego, co trafia do okna, jest więc równie ważny jak jego rozmiar. Strategia „wrzućmy modelowi wszystkie dokumenty firmy” przegrywa dwa razy: na jakości i, jak pokazuje rachunek niżej, na koszcie.
Ten sam dokument w każdym zapytaniu mnoży rachunek
Skoro model nie pamięta, dokument potrzebny do odpowiedzi musi trafić do okna przy każdym pytaniu, a Ty płacisz za niego za każdym razem. Nasz rachunek na cenniku Anthropic z 3.10.2026: Claude Sonnet 5.5 kosztuje 2 $ za milion tokenów wejścia. Wielkości dokumentu i fragmentów to nasze założenia, a nie średnie rynkowe.
- Jedno pytanie do dokumentu o objętości 100 000 tokenów, na przykład regulaminu z załącznikami: 100 000 × 2 $ / 1 000 000 = 0,20 $ za sam dokument, zanim doliczysz pytanie i odpowiedź.
- Rozmowa z 10 pytaniami o ten dokument: dokument jedzie w historii przy każdym zapytaniu, więc to co najmniej 1 000 000 tokenów wejścia i co najmniej 2 $ za sam dokument.
- 1 000 pojedynczych pytań w miesiącu: 200 $ za wejście. Gdyby system zamiast całego dokumentu wysyłał do modelu tylko pasujące fragmenty, na przykład 5 000 tokenów, byłoby to 0,01 $ za pytanie i 10 $ za tysiąc pytań, czyli 20 razy mniej.
Rachunek nie uwzględnia pamięci podręcznej, rabatów ani tokenów wyjścia, a dwie rzeczy mogą go zmienić. Pierwsza to pamięć podręczna (prompt caching). U Anthropic odczyt z niej kosztuje dla Claude Sonnet 5.5 5% ceny wejścia, czyli 0,10 $ za milion tokenów (odczyt cennika 20.10.2026), a zapis 1,25 albo 2 razy tyle co zwykłe wejście, zależnie od tego, czy pamięć trwa 5 minut, czy godzinę. Anthropic przypomina jednak, że tokeny z pamięci podręcznej nadal zajmują okno, więc problem spadku trafności zostaje. Druga to długi kontekst u OpenAI: w cenniku API GPT-6.1 Sol kosztuje 2 $ za milion tokenów wejścia w zapytaniach do 272 tys. tokenów wejścia, a powyżej tej granicy 4 $, przy wyjściu 15 $ zamiast 10 $.
Podejście, w którym system najpierw wyszukuje w firmowych dokumentach fragmenty pasujące do pytania i dopiero je przekazuje modelowi, nazywa się RAG (retrieval-augmented generation). Ogranicza oba problemy naraz: mniej tokenów w oknie to niższy rachunek i mniej szumu, w którym model może się pogubić. Jakość odpowiedzi zależy wtedy od jakości wyszukiwania i samych dokumentów.
Ile kosztuje LLM — od czego zależy rachunek
Za LLM płacisz na jeden z dwóch sposobów: abonamentem za osobę w aplikacji albo za tokeny, gdy model działa przez API w Twoim systemie. Abonament jest przewidywalny i obejmuje gotowy interfejs. Copilot i Gemini w pakietach biurowych porównujemy w tekście Google Workspace czy Microsoft 365. Przy API płacisz za każdy przetworzony token, a Anthropic, OpenAI i Google podają ceny w dolarach za milion tokenów (Anthropic, OpenAI, Google; odczyt 3.10.2026, cennik Anthropic ponownie 20.10.2026).
O wysokości rachunku w API decydują cztery dźwignie.
1. Wybór modelu. U jednego dostawcy najtańszy i najdroższy z obecnych modeli dzieli przepaść (nasza arytmetyka na cennikach). W OpenAI GPT-6 Luna kosztuje 0,10 $ za milion tokenów wejścia, a GPT-6 Astra 10 $, czyli 100 razy więcej. W Anthropic Claude Haiku 5.5 kosztuje od 0,10 $, a Claude Fable 5.1 10 $, czyli także 100 razy więcej. To rozrzut cen, a nie ranking jakości. Do wielu prostych zadań, jak klasyfikacja zgłoszeń czy wyciąganie danych z formularza, warto zacząć od tańszego modelu i sprawdzić go na własnych przykładach.
2. Wyjście kosztuje 5 razy więcej niż wejście. Tak jest w standardowych cenach wszystkich modeli, które cytujemy (nasza arytmetyka): Claude Sonnet 5.5 2 $ i 10 $, Claude Haiku 5.5 0,10 $ i 0,50 $ przy poleceniach do 100 tys. tokenów (powyżej 0,50 $ i 2,50 $), GPT-6.1 Sol 2 $ i 10 $, GPT-6 Luna 0,10 $ i 0,50 $. Gemini 3.8 Flash kosztuje 0,75 $ za wejście i 3,75 $ za wyjście do 31.12.2026, a od 1.01.2027 Google podnosi te ceny dwukrotnie, do 1,50 $ i 7,50 $. Długie odpowiedzi kosztują więc więcej niż długie pytania. Dochodzi do tego rozumowanie: według OpenAI modele rozumujące zużywają tokeny na wewnętrzne rozumowanie, którego nie widać w odpowiedzi, a rozliczane są one jak tokeny wyjścia.
3. Historia i dokumenty w każdym zapytaniu. Wszystko, co wraca do okna przy kolejnym pytaniu, płacisz od nowa. W długich rozmowach i przy dużych dokumentach to często największa pozycja.
4. Tokenizer. Ta sama cena za milion tokenów nie oznacza tego samego kosztu tekstu. Anthropic pisze w cenniku, że modele Claude od wersji 4.7 używają nowego tokenizera, który daje około 30% więcej tokenów dla tego samego tekstu, a w dokumentacji liczenia tokenów odradza przenoszenie pomiarów ze starszych modeli. Do tego dochodzi język, co pokazał nasz pomiar. Ceny modeli porównuje się na własnym tekście, a nie w tabelce.
Przetwarzanie wsadowe, czyli zadania, na których wynik możesz poczekać, kosztuje u Anthropic, OpenAI i Google o połowę mniej. Z kolei przetwarzanie wyłącznie w USA kosztuje u Anthropic 1,1 raza tyle co standardowe.
Ile kosztuje jedna odpowiedź czatu, a ile wieloetapowe zadanie, policzyliśmy w złotówkach w artykule o agencie AI. Tokeny to jednak tylko koszt działania. Koszt wdrożenia, czyli integracji z systemami, przygotowania danych i testów, zależy od projektu, a niezależnych badań tych kosztów w Polsce nie znaleźliśmy.
Aplikacja, API czy własny model — trzy sposoby korzystania z LLM
Z modelu językowego możesz korzystać na trzy sposoby i każdy oznacza inny rachunek, inną odpowiedzialność za dane i kogoś innego, kto dba o aktualizacje. Naszym zdaniem ten wybór warto zrobić przed wyborem konkretnego modelu.
Tabela-diagram · trzy sposoby korzystania z modelu językowego
| Aplikacja w planie firmowym | API dostawcy | Własny model na serwerze | |
|---|---|---|---|
| Za co płacisz | Aplikacja w planie firmowymAbonament za osobę | API dostawcyTokeny wejścia i wyjścia | Własny model na serwerzeSprzęt, prąd i ludzie |
| Czy dostawca trenuje na danych | Aplikacja w planie firmowymZależy od warunków planu | API dostawcyOpenAI i Anthropic domyślnie nie, darmowy poziom Gemini API używa treści do ulepszania produktów, płatny nie | Własny model na serwerzeDane nie wychodzą z Twojego serwera |
| Gdzie dane są przetwarzane | Aplikacja w planie firmowymZależy od planu | API dostawcyRegion do wyboru, zwykle za dopłatą, albo przez platformę chmurową | Własny model na serwerzeTwój serwer |
| Kto aktualizuje i moderuje | Aplikacja w planie firmowymDostawca | API dostawcyDostawca model, a Ty swoją aplikację | Własny model na serwerzeTy |
Aplikacja (ChatGPT, Claude, Gemini, Copilot w planie firmowym). Płacisz abonament za osobę i dostajesz gotowe narzędzie. O tym, co dzieje się z danymi, decydują warunki konkretnego planu, a plan prywatny i firmowy to dwie różne umowy. Zanim pracownicy zaczną wklejać do czatu dokumenty klientów, ktoś w firmie powinien przeczytać warunki planu, za który płacicie, i ustalić zasady korzystania. Plany firmowe ChatGPT, Copilota i Gemini, ich ceny i umowy powierzenia porównujemy w artykule ChatGPT Business, Copilot czy Gemini dla firmy.
API dostawcy. Model działa w Twoim systemie, a płacisz za tokeny. Warunki dla danych dostawcy opisują wprost:
- OpenAI: od 1.03.2023 dane wysyłane do API nie są używane do trenowania ani ulepszania modeli, chyba że wyraźnie się na to zgodzisz. Domyślnie OpenAI przechowuje logi do wykrywania nadużyć do 30 dni, o ile prawo nie wymaga dłużej. Wybór regionu przetwarzania danych trzeba uzgodnić z działem sprzedaży. Dla regionu innego niż USA, w tym UE, OpenAI musi dodatkowo zatwierdzić firmę do zmienionych zasad monitorowania nadużyć, a firma podpisuje aneks o przechowywaniu danych. Dla modeli wydanych od 5.03.2026 przetwarzanie w wybranym regionie jest o 10% droższe (Data controls).
- Anthropic: domyślnie nie używa wejść ani wyjść z produktów komercyjnych, w tym z API, do trenowania modeli (Privacy Center). Według warunków handlowych klient zachowuje prawa do danych wejściowych i jest właścicielem wyników. Miejsce przetwarzania w API wybierasz parametrem, dla którego dokumentacja wymienia dwie wartości: „global” i „us”. Ta druga działa w modelach od Claude 4.6 i kosztuje 1,1 raza tyle co standardowa (Data residency). W Amazon Bedrock i Google Cloud region wyznacza adres usługi albo profil, a przetwarzającym dane jest dostawca chmury.
- Google: w darmowym poziomie Gemini API treści są używane do ulepszania produktów Google, w płatnym nie (cennik Gemini API). Darmowy dostęp płacisz więc danymi.
Pytania do dostawcy chmury o to, gdzie leżą dane i kto za co odpowiada, zebraliśmy w tekście o bezpieczeństwie danych w chmurze.
Własny model na serwerze (open source, lokalnie). Pobierasz model z otwartą licencją i uruchamiasz go na własnym sprzęcie. Dane nie wychodzą poza Twój serwer, ale wszystko, co przy API robi dostawca, robisz sam: kupujesz albo wynajmujesz sprzęt z kartą graficzną, aktualizujesz model, pilnujesz bezpieczeństwa i moderujesz treści. Twórcy Bielika piszą w karcie modelu wprost, że model „nie ma żadnych mechanizmów moderacji”. Skalę sprzętu pokazuje poradnik Bielika (23.08.2025) dla modelu 11B (w przykładzie wersja 2.6): model wytrenowany w precyzji 16-bitowej wymaga do załadowania co najmniej 22 GB pamięci, a wersja skwantyzowana, czyli skompresowana, Q8 — 11 GB. Na karcie graficznej osiąga około 50 tokenów na sekundę, w zwykłej pamięci RAM około 1–5. To reguła kciuka wydawcy dla jednego modelu, a nie ogólna norma. Poradnik wymienia do uruchamiania narzędzie LM Studio. Innym takim narzędziem jest Ollama, ale wersje Bielika w jej katalogu publikują różne konta, więc przed pobraniem sprawdź, kto wgrał plik. Ile kosztuje taki serwer w złotówkach i od ilu zapytań model lokalny wychodzi taniej niż API, nie da się rzetelnie podać bez konkretnego projektu; wiarygodnego źródła na ten temat nie znaleźliśmy.
Polski model językowy: Bielik i PLLuM
Polskie modele są otwarte, darmowe do pobrania i część z nich można używać komercyjnie, ale w firmie oznacza to zwykle samodzielne uruchomienie na własnym sprzęcie, a nie gotową usługę z umową. Dla firmy liczą się trzy pytania: co wolno z licencji, ile sprzętu trzeba i czy model poradzi sobie z Twoim zadaniem.
Bielik to rodzina otwartych modeli rozwijana przez Fundację SpeakLeash i społeczność Bielika. Według karty modelu Bielik-11B-v3.0-Instruct ma 11 mld parametrów, powstał we współpracy SpeakLeash i ACK Cyfronet AGH, był trenowany na superkomputerach Athena i Helios, obsługuje 32 języki europejskie i jest zoptymalizowany pod polski. Licencja Apache 2.0 pozwala na użycie komercyjne, co bielik.ai podkreśla wprost. W tej samej rodzinie są mniejsze modele 1.5B, 4.5B i 7B, też na Apache 2.0. Uwaga na starsze wersje: Bielik-7B-Instruct-v0.1 ma licencję CC BY-NC 4.0, czyli tylko do użytku niekomercyjnego. Pobranie Bielik-11B-v3.0-Instruct z Hugging Face wymaga akceptacji warunków.
PLLuM (Polish Large Language Model) to według pllum.org.pl otwarte polskie modele językowe, które „powstały z myślą o suwerenności cyfrowej Polski”. W 2024 r. tworzyło je konsorcjum polskich instytucji naukowych, od 2025 r. rozwija je sojusz HIVE AI. Według wydawcy właścicielem modeli z pierwszego projektu jest Ministerstwo Cyfryzacji, a kontynuację (HIVE 2) minister finansuje dotacją 5 999 102,67 zł. Rodzina 2512 z karty modelu obejmuje modele 4B, 8B, 12B i 70B zbudowane na Gemma 3, Llama 3.1 i Mistral Nemo. Modele oznaczone „Non-commercial” są tylko do użytku niekomercyjnego, pozostałe wydawca udostępnia na licencji Apache 2.0 albo Llama 3.1, również komercyjnie. Licencja Llama 3.1 ma własne warunki Mety, więc przed wdrożeniem trzeba je przeczytać.
PLLuM działa lokalnie na serwerze z kartą graficzną. Dla systemu wyszukiwania w dokumentach (RAG) wydawca podaje pamięć karty graficznej osobno dla każdego składnika: model 8B jako generator odpowiedzi to około 34 GB, 12B około 48 GB, a 70B około 168 GB; składniki wyszukiwania i ponownego szeregowania wyników (reranking) potrzebują dodatkowo 24–48 GB. To liczby wydawcy dla modelu działającego w takim systemie, a nie rozmiar pliku modelu, więc nie porównuj ich wprost z 22 GB Bielika. Karta modelu ostrzega, że PLLuM, jak inne LLM, może podawać treści nieprawdziwe lub zmyślone.
„Polski” nie znaczy automatycznie „lepszy w Twoim zadaniu”. Wyniki testów na stronach modeli to deklaracje twórców, a nie niezależne porównanie. Model sprawdzasz na własnych dokumentach i pytaniach.
LLM a AI Act — kto ma obowiązki
Obowiązki z AI Act dotyczące samych modeli ciążą na ich dostawcy, czyli na tym, kto model opracował i wprowadza do obrotu. Firma, która korzysta z gotowego modelu przez API, nie staje się przez to jego dostawcą. Duży model językowy to zwykle „model AI ogólnego przeznaczenia” w rozumieniu art. 3 pkt 63: trenowany dużą ilością danych, „wykazuje znaczną ogólność” i można go zintegrować z różnymi systemami. Komisja Europejska w pytaniach i odpowiedziach podaje orientacyjne kryterium: moc obliczeniowa trenowania powyżej 10^23 FLOP i zdolność generowania języka (tekstu albo dźwięku), obrazów lub wideo z tekstu.
Od 2.08.2025 dostawców takich modeli obowiązuje art. 53: dokumentacja techniczna, informacje dla firm integrujących model, polityka praw autorskich i streszczenie treści użytych do trenowania. Dwa pierwsze obowiązki nie dotyczą modeli na bezpłatnej otwartej licencji z jawnymi wagami (art. 53 ust. 2), chyba że model niesie ryzyko systemowe.
Firma, która wbudowuje model w swój system, ma obowiązki jako dostawca albo podmiot stosujący systemu AI, i to, jak pisze Komisja, niezależnie od tego, czy staje się dostawcą modelu. Przykład to art. 50: od 2.08.2026 dostawca czatu rozmawiającego z ludźmi musi zadbać, by rozmówca wiedział, że rozmawia z AI, chyba że to oczywiste. Role dostawcy i podmiotu stosującego, terminy i kary opisujemy w artykule AI Act dla firmy, obowiązki agenta w tekście o agencie AI, a kalendarz wszystkich przepisów w dziale AI w firmie.
Dostrajanie to szara strefa. Firma, która dostraja albo modyfikuje istniejący model, może stać się dostawcą nowego modelu, a Komisja nazywa pytanie, kiedy to następuje, „trudnym”. Według niewiążących wytycznych dla dostawców modeli dotyczy to tylko znaczących modyfikacji, nie drobnych zmian. Granicę w konkretnym projekcie wyznacza prawnik; to opis przepisów, nie porada prawna.
Jak wybrać LLM do zadania w firmie — sześć pytań
Zamiast pytać, który model jest najlepszy, zapytaj, który wystarczy do Twojego zadania przy akceptowalnym ryzyku i koszcie. Poniższa lista to nasza rama, zbudowana na źródłach cytowanych wyżej:
- Jakie to zadanie i jaki błąd jest akceptowalny? Streszczenie notatki dla zespołu znosi więcej pomyłek niż odpowiedź wysyłana klientowi albo dane w fakturze.
- Jakie dane trafią do modelu i czy wolno je wysłać na zewnątrz? Dane osobowe, tajemnica przedsiębiorstwa i dokumenty klientów to różne kategorie. Zacznij od tego, gdzie naprawdę leżą dane firmy.
- Gdzie model przetwarza dane i czy dostawca na nich trenuje? Sprawdź warunki planu albo API, a nie stronę marketingową: darmowy poziom Gemini API używa treści do ulepszania produktów Google, API OpenAI i Anthropic domyślnie nie trenują na danych klienta.
- Ile tokenów zużywa jedno zadanie? Policz to na własnym tekście licznikiem dostawcy, z historią i dokumentami, które naprawdę wyślesz, a potem pomnóż przez liczbę zadań w miesiącu.
- Jak model radzi sobie z Twoimi przykładami? Przygotuj kilkadziesiąt prawdziwych przypadków z oczekiwanym wynikiem i przepuść je przez dwa lub trzy modele, każdy kilka razy. To powie Ci więcej niż publiczne rankingi.
- Kto sprawdza wynik, zanim trafi dalej? Model się myli, więc w procesie musi być miejsce, w którym człowiek albo reguła wyłapuje błąd.
My w projektach korzystamy z modeli OpenAI i Anthropic przez API. Wybór konkretnego modelu zawsze zaczynamy od pytań 1–3, bo od nich zależy, czy w ogóle wchodzi w grę model przez API, czy potrzebny jest model na własnym serwerze.
Najczęstsze pytania o LLM
Co oznacza skrót LLM?
LLM to skrót od angielskiego „large language model”, czyli duży model językowy: program wytrenowany na ogromnej ilości tekstu, który przewiduje kolejny fragment tekstu i w ten sposób pisze odpowiedź. Ten sam skrót oznacza też LL.M (Master of Laws), czyli studia prawnicze, i stąd część wyników wyszukiwania dotyczy uczelni, a nie AI.
Czy ChatGPT to LLM?
Nie dokładnie. ChatGPT to aplikacja: interfejs, historia rozmów i dodatkowe funkcje. Odpowiedzi pisze w niej duży model językowy OpenAI. Tak samo Claude to asystent oparty, jak pisze Anthropic, na dużym modelu językowym. Te same modele dostawcy udostępniają też przez API, z innym cennikiem i innymi warunkami dla danych.
Ile tokenów ma polskie słowo?
Zależy od modelu i tekstu. Przeliczniki dostawców, na przykład „1 token to około 4 znaki”, dotyczą angielskiego. W naszym pomiarze otwartą biblioteką OpenAI tiktoken na motywach 97–99 AI Act polski tekst miał w kodowaniu o200k_base średnio 2,03 tokenu na słowo, a angielski 1,15, czyli cały polski fragment liczył 1,67 raza więcej tokenów niż jego angielska wersja. W starszym kodowaniu cl100k_base było to 2,00 raza. Inne modele, w tym Claude i Gemini, tokenizują inaczej, więc koszt najlepiej policzyć na własnym tekście licznikiem wybranego dostawcy.
Czy model uczy się na danych, które mu wysyłam?
W trakcie rozmowy nie: model korzysta tylko z tego, co jest w oknie kontekstowym, i sam niczego między zapytaniami nie zapamiętuje. To aplikacja albo Twój system decyduje, co dołączyć do kolejnego zapytania. Czy dostawca użyje Twoich danych do trenowania kolejnych modeli, zależy od sposobu korzystania. API OpenAI (od 1.03.2023) i API Anthropic domyślnie nie trenują na danych klienta, a w darmowym poziomie Gemini API treści są używane do ulepszania produktów Google. W aplikacjach decydują warunki konkretnego planu.
Czy można uruchomić LLM na własnym serwerze?
Tak, jeśli model ma otwartą licencję, jak polskie Bielik i PLLuM. Potrzebny jest sprzęt: według poradnika Bielika model 11B wymaga co najmniej 22 GB pamięci w precyzji 16-bitowej albo 11 GB po kwantyzacji Q8, a wydawca PLLuM podaje dla modelu 12B jako generatora odpowiedzi w systemie RAG około 48 GB pamięci karty graficznej, plus pamięć dla składników wyszukiwania. Sprawdź licencję, bo część modeli jest tylko do użytku niekomercyjnego, i pamiętaj, że aktualizacje, bezpieczeństwo i moderacja treści są wtedy po Twojej stronie.
Czym różni się okno kontekstowe od wiedzy modelu?
Wiedza modelu pochodzi z danych treningowych i kończy się na dacie odcięcia, na przykład według Anthropic czerwiec 2026 r. dla Claude Sonnet 5.5. Okno kontekstowe to tekst, który wysyłasz w konkretnym zapytaniu: instrukcja, historia rozmowy, dokumenty. Model korzysta z jednego i drugiego, ale o Twojej firmie i o wydarzeniach po dacie odcięcia wie tylko to, co znajdzie się w oknie.
Powiązane artykuły
Sztuczna inteligencja
RAG AI — jak sztuczna inteligencja odpowiada na podstawie dokumentów firmy
RAG AI to sposób, w jaki model językowy odpowiada na podstawie dokumentów firmy. Jak działa, co psuje odpowiedzi, ile kosztuje i jak zacząć bez ryzyka.
Sztuczna inteligencja
ChatGPT Business, Copilot czy Gemini dla firmy — plany, ceny i dane
ChatGPT Business, Copilot czy Gemini dla firmy: co zmienia plan firmowy, ile kosztuje użytkownik, umowa powierzenia i co masz już w pakiecie biurowym.
Sztuczna inteligencja
Halucynacje AI — dlaczego sztuczna inteligencja zmyśla i jak firma może to wyłapać
Halucynacje AI to pewnie podane, ale fałszywe odpowiedzi modelu. Skąd się biorą, gdzie kosztują firmę i jak ułożyć proces, który je wyłapie przed klientem.
Sztuczna inteligencja
AI Act dla firmy — obowiązki, terminy i kary po zmianach z 2026 roku
AI Act dla firmy: co musisz zrobić, gdy używasz AI, od kiedy obowiązują przepisy po zmianie z lipca 2026, co dodaje polska ustawa i jakie grożą kary.
Sztuczna inteligencja
Jak stworzyć agenta AI w firmie — od procesu do pierwszej działającej wersji
Jak stworzyć agenta AI w firmie krok po kroku: proces, narzędzia i uprawnienia, człowiek w pętli, limity kosztu, testy i ochrona przed prompt injection.
Automatyzacja i integracje
n8n — co to jest i kiedy ma sens w firmie
n8n co to jest? Narzędzie do automatyzacji z węzłami AI, w chmurze lub na własnym serwerze. Licencja, ceny, bezpieczeństwo i porównanie z Make i Zapier.
Gdzie AI naprawdę się u Was opłaci?
Opowiedzcie, które zadania zabierają Wam dziś najwięcej czasu. Sprawdzimy, czy wystarczy gotowy asystent, czy potrzebne jest wdrożenie na Waszych danych. Jeśli wystarczy ChatGPT w planie firmowym — powiemy to wprost.