
Sztuczna inteligencja22 min czytania4245 słówRedakcja dvnt
Jak stworzyć agenta AI w firmie — od procesu do pierwszej działającej wersji
Jak stworzyć agenta AI w firmie krok po kroku: proces, narzędzia i uprawnienia, człowiek w pętli, limity kosztu, testy i ochrona przed prompt injection.
Jak stworzyć agenta AI w firmie? Zacznij od procesu, nie od narzędzia: opisz jedno zadanie i to, po czym poznasz, że zostało wykonane, daj modelowi kilka wąskich narzędzi z minimalnymi uprawnieniami, ustaw zatwierdzanie przez człowieka, limit kroków i budżetu, a przed uruchomieniem sprawdź agenta na zestawie prawdziwych zadań. Więcej autonomii dokładasz dopiero wtedy, gdy logi pokażą, że agent radzi sobie z tym, co już ma.
Tak radzą sami dostawcy modeli. Anthropic, twórca modeli Claude, w tekście „Building effective agents” (19.12.2024) zaleca szukać najprostszego rozwiązania i zwiększać złożoność tylko wtedy, gdy to potrzebne — czasem oznacza to, że agenta w ogóle nie trzeba budować. OpenAI w przewodniku „A practical guide to building agents” (2025) pisze, że klienci częściej odnoszą sukces, rozwijając agenta stopniowo, niż budując od razu w pełni autonomiczną, złożoną architekturę. To porady firm, które sprzedają modele, a mimo to radzą ostrożność, nie rozmach.
Zakładamy, że wiesz już, czym jest agent i że Twój proces go potrzebuje; jeśli nie, zacznij od artykułu agent AI w firmie. Tu znajdziesz metodę w siedmiu krokach, ochronę przed prompt injection, cztery drogi do pierwszej wersji i to, co zaprojektowaliśmy w czacie AI dla naszej strony. Bez kodu i bez rankingu narzędzi. Stan dokumentacji na 3.10.2026.
Zanim zaczniesz: agent, przepływ czy jedno wywołanie modelu
Agent to najbardziej autonomiczny, a więc najdroższy i najtrudniejszy do przewidzenia z trzech poziomów; zanim go zbudujesz, sprawdź, czy nie wystarczy jeden z dwóch niższych. Anthropic pisze wprost, że autonomia agentów oznacza wyższe koszty i ryzyko kumulowania się błędów. Podstawową cegiełką systemów agentowych jest według Anthropic model językowy wzbogacony o wyszukiwanie, narzędzia i pamięć (augmented LLM).
Najniżej jest jedno dobrze przygotowane wywołanie takiego modelu. Pośrodku są przepływy (workflows): kolejność kroków ustala programista, a model wykonuje poszczególne kroki. Anthropic opisuje pięć typowych wzorców przepływów — od łańcucha poleceń (prompt chaining) po ewaluatora z optymalizatorem (evaluator-optimizer), w którym jeden model generuje odpowiedź, a drugi ją ocenia i odsyła uwagi. Na górze jest agent, który sam decyduje o kolejnych krokach.
Test „czy umiesz zapisać regułę” i trzy kryteria OpenAI, które odróżniają proces dla agenta od procesu dla automatyzacji, opisaliśmy w artykule o agencie AI. Jeśli proces da się zapisać jako zamkniętą listę „jeśli… to…”, budujesz przepływ, nie agenta; tak pracujemy przy automatyzacji procesów. Dalej zakładamy, że reguły się nie zamykają, a wyjątki rozstrzyga dziś człowiek.
Jak stworzyć agenta AI: siedem kroków od procesu do pierwszej wersji
Agent AI krok po kroku to siedem decyzji, z których każda zostawia konkretny dokument albo ustawienie — i wszystkie zapadają przed uruchomieniem.
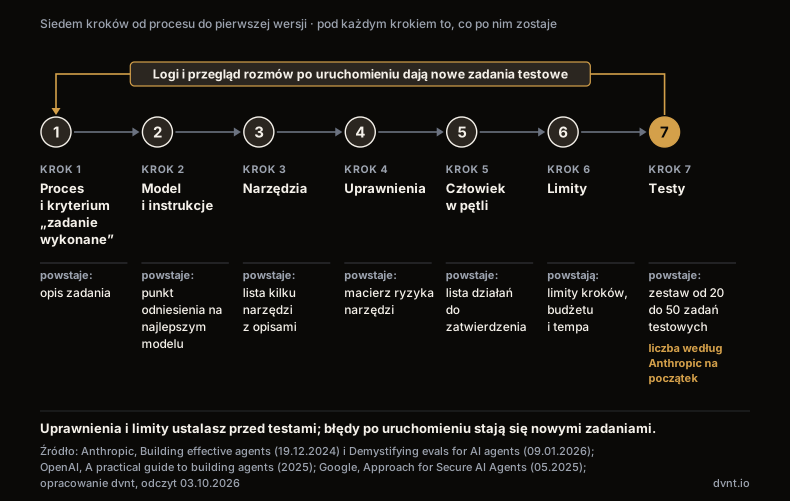
Uprawnienia, zatwierdzanie i limity ustalasz przed testami, bo testy mają sprawdzić agenta w takiej postaci, w jakiej trafi do ludzi, a nie wersję bez hamulców. Każdy błąd zauważony po uruchomieniu staje się nowym zadaniem testowym. Kroki 4–7 rozpisują w praktyce trzy zasady, na których Google w dokumencie „Google’s Approach for Secure AI Agents” (maj 2025) opiera bezpieczeństwo agenta: agent ma wyraźnie określonych ludzi, którzy nim kierują, jego uprawnienia są ograniczone, a jego działania i plan da się obserwować.
Krok 1: jeden proces i kryterium „zadanie wykonane”
Pierwszy agent obsługuje jeden proces, a jego specyfikacja zaczyna się od zdania, po czym poznasz, że zadanie zostało wykonane. OpenAI radzi budować instrukcje agenta z dokumentów, które firma już ma — procedur, skryptów obsługi klienta, polityk — i od razu uwzględnić przypadki brzegowe, na przykład co zrobić, gdy klient poda niepełne dane albo zada nieoczekiwane pytanie.
Kryterium ma być konkretne i mierzalne. Anthropic w dokumentacji „Define success criteria and build evaluations” (odczyt 3.10.2026) pisze, że budowa aplikacji na modelu językowym zaczyna się od jasnego określenia kryteriów sukcesu, a dopiero potem projektuje się testy, które je mierzą. Jeśli nie umiesz napisać testu, nie wiesz, co budujesz.
Najczęstszy błąd to kryterium oparte na tym, co agent mówi. „Agent potwierdził klientowi rezerwację” nie jest kryterium. „Rezerwacja istnieje w kalendarzu” — jest.
Co powinno znaleźć się w specyfikacji agenta, zanim powstanie pierwsza linia kodu (nasza lista na podstawie tych źródeł):
- zadanie i wejście — jaki proces, kto lub co go uruchamia, jakie dane dostaje agent;
- kiedy zadanie jest wykonane — stan w systemie, nie deklaracja modelu;
- czego agent nie robi — tematy i działania poza zakresem;
- co zatwierdza człowiek — lista działań, przed którymi agent się zatrzymuje;
- limity — maksymalna liczba kroków na zadanie i budżet;
- kto czyta logi i jak często.
Pierwsza wersja ma być mała: jeden proces, kilka narzędzi, ograniczona grupa użytkowników. Jak planować taki zakres, opisujemy w tekście o MVP aplikacji webowej.
Krok 2: model i instrukcje — najpierw najlepszy, potem tańszy
Prototyp buduj na najlepszym dostępnym modelu, a tańszy wstawiaj dopiero tam, gdzie testy pokażą, że wystarcza. OpenAI w przewodniku pisze: zbuduj prototyp na najbardziej zdolnym modelu, żeby ustalić punkt odniesienia, a potem podmieniaj na mniejsze i sprawdzaj, czy wyniki są nadal akceptowalne. Koszt i czas odpowiedzi optymalizujesz dopiero wtedy, gdy wiesz, jaką dokładność musisz utrzymać.
Druga zasada OpenAI: najpierw w pełni wykorzystaj jednego agenta. Kolejni agenci dają czytelny podział zadań, ale dokładają złożoności i narzutu, więc często wystarcza jeden agent z narzędziami. Podział OpenAI radzi rozważyć dopiero wtedy, gdy instrukcje obrastają w zbyt wiele warunków albo narzędzia zaczynają się pokrywać.
W projekcie czatu AI na naszej stronie rozmowę ma prowadzić Claude Sonnet 5.5, a stały formularz kwalifikacji wypełniać tańszy Claude Haiku 4.5, bo przy wydobywaniu danych do sztywnego schematu tańszy model wystarcza. To decyzja projektowa — czat jeszcze nie działa, więc nie mamy wyników, które by ją potwierdzały. Jak wybierać model i czym są tokeny, wyjaśniamy w artykule o dużych modelach językowych (LLM).
Krok 3: narzędzia — mniej, węższe i dobrze opisane
Narzędzie (tool) to funkcja, którą model może wywołać, ale wykonuje ją Twój kod — i to Twój kod decyduje, co naprawdę się stanie. Według dokumentacji tool use Anthropic (odczyt 3.10.2026) model na podstawie prośby użytkownika i opisu narzędzia decyduje, kiedy je wywołać, i zwraca ustrukturyzowane wywołanie, które wykonuje Twoja aplikacja. W praktyce narzędzie to najczęściej API któregoś z Twoich systemów — do pobierania danych, na przykład z CRM, albo do działań, takich jak wysłanie maila czy aktualizacja rekordu.
Narzędzi ma być mniej, niż podpowiada intuicja. Anthropic w tekście „Writing effective tools for agents — with agents” (11.09.2025) pisze, że więcej narzędzi nie zawsze daje lepsze wyniki, a częsty błąd to narzędzia, które jedynie owijają istniejące funkcje albo punkty API. Radzi zbudować kilka przemyślanych narzędzi pod konkretne zadania — na przykład takie, które wyszukuje kontakt w książce adresowej (search_contacts), zamiast takiego, które zwraca listę wszystkich kontaktów (list_contacts). Za dużo narzędzi albo narzędzia, które się pokrywają, rozpraszają agenta.
Opis narzędzia to część polecenia. Anthropic zaleca poświęcić definicjom narzędzi tyle samo pracy co całemu poleceniu i projektować je tak, żeby trudno było popełnić błąd (zasada poka-yoke). Przy własnym agencie Anthropic więcej czasu poświęcił narzędziom niż poleceniu, a gdy narzędzie zaczęło wymagać bezwzględnych ścieżek plików, model przestał się mylić.
Narzędzia kosztują w każdym kroku. Nazwy, opisy i schematy narzędzi idą w każdym zapytaniu jako tokeny, a cennik Claude API (odczyt 3.10.2026) podaje, że samo włączenie narzędzi dokłada w Claude Sonnet 5.5 286 tokenów instrukcji systemowej. Ile kosztuje jeden krok agenta, policzyliśmy w artykule o agencie AI.
Wiedzę firmy agent zwykle dostaje jako kolejne narzędzie — wyszukiwanie w dokumentach, które opisujemy w tekście o RAG. Narzędzia można też podłączać przez MCP (Model Context Protocol), standard łączenia narzędzi z modelami, który opisujemy w osobnym artykule.
Krok 4: uprawnienia — agent może tyle, ile pozwoli system, nie polecenie
Polecenie „nie wysyłaj maili” nie jest zabezpieczeniem; zabezpieczeniem jest narzędzie, które maili wysłać nie potrafi. OWASP, projekt społeczności bezpieczeństwa aplikacji, nazywa to ryzyko nadmierną sprawczością (LLM06:2025 Excessive Agency, aktualizacja 5.05.2025): agent wykonuje szkodliwe działanie w odpowiedzi na błędny albo zmanipulowany wynik modelu, niezależnie od tego, czy przyczyną była halucynacja, czy wstrzyknięte polecenie. Źródłem są według OWASP za szerokie funkcje, za szerokie uprawnienia albo za dużo autonomii.
Przykład OWASP: asystent ma streszczać maile, ale jego wtyczka do skrzynki potrafi też wysyłać wiadomości, więc złośliwie przygotowany mail przychodzący nakłania model, żeby wysłał nią dane. Szkody nie byłoby, gdyby wtyczka umiała tylko czytać, gdyby dostęp do skrzynki miał zakres tylko do odczytu albo gdyby „wyślij” klikał użytkownik.
OpenAI radzi ocenić ryzyko każdego narzędzia — niskie, średnie albo wysokie — według tego, czy tylko czyta, czy zapisuje, czy działanie da się cofnąć, jakich uprawnień konta wymaga i jaki ma skutek finansowy. Poziom ryzyka ma uruchamiać działania automatyczne: dodatkowe sprawdzenie przed funkcją wysokiego ryzyka albo przekazanie sprawy człowiekowi.
Przykładowe narzędzia · kryteria z metody OpenAI · poziom i kontrola przypisane przez nas
| Narzędzie (przykład) | Odczyt czy zapis | Czy odwracalne | Skutek finansowy | Poziom ryzyka | Kontrola |
|---|---|---|---|---|---|
| Wyszukiwanie w bazie wiedzy | Odczyt czy zapisodczyt | Czy odwracalnenie dotyczy | Skutek finansowybrak | Poziom ryzykaniskie | Kontrolaautomatycznie |
| Podgląd zamówienia | Odczyt czy zapisodczyt | Czy odwracalnenie dotyczy | Skutek finansowybrak | Poziom ryzykaniskie | Kontrolaautomatycznie |
| Wolne terminy w kalendarzu | Odczyt czy zapisodczyt | Czy odwracalnenie dotyczy | Skutek finansowybrak | Poziom ryzykaniskie | Kontrolaautomatycznie |
| Szkic odpowiedzi do klienta | Odczyt czy zapiszapis szkicu | Czy odwracalneodwracalne | Skutek finansowybrak | Poziom ryzykaniskie | Kontrolaautomatycznie |
| Notatka w CRM | Odczyt czy zapiszapis | Czy odwracalneodwracalne | Skutek finansowybrak | Poziom ryzykaśrednie | Kontrolaautomatycznie z logiem i limitem |
| Wysłanie maila do klienta | Odczyt czy zapiszapis | Czy odwracalnenieodwracalne | Skutek finansowybrak bezpośredniego | Poziom ryzykawysokie | Kontrolazatwierdza człowiek |
| Anulowanie zamówienia | Odczyt czy zapiszapis | Czy odwracalnenieodwracalne | Skutek finansowytak | Poziom ryzykawysokie | Kontrolazatwierdza człowiek |
| Zwrot pieniędzy | Odczyt czy zapiszapis | Czy odwracalnenieodwracalne | Skutek finansowytak | Poziom ryzykawysokie | Kontrolazatwierdza człowiek |
| Płatność | Odczyt czy zapiszapis | Czy odwracalnenieodwracalne | Skutek finansowytak | Poziom ryzykawysokie | Kontrolazatwierdza człowiek |
WNIOSEKPrzypisanie poziomów to ilustracja dvnt, nie zalecenie dostawcy.
Najważniejsza zasada tego kroku: uprawnienia egzekwuje system docelowy, nie model. OWASP nazywa to pełną kontrolą pośredniczącą (complete mediation): autoryzację wdraża się w systemach, do których agent się odwołuje, zamiast polegać na ocenie modelu. Google w dokumentacji bezpieczeństwa ADK (Agent Development Kit, odczyt 3.10.2026) pokazuje to na przykładzie: jeśli konto narzędzia ma do zasobu prawo tylko do odczytu, narzędzie nie wykona zapisu, cokolwiek zdecyduje model. W dokumencie o bezpiecznych agentach Google dodaje, że agent nie może sam rozszerzać swoich uprawnień poza zatwierdzony zakres, a użytkownik musi móc sprawdzić i odebrać każde uprawnienie, które mu przekazał.
Druga decyzja: na czyim koncie działa agent. Według dokumentacji ADK na własnym koncie wszystkie działania wyglądają jak działania agenta, więc logi muszą przypisywać je do konkretnych użytkowników; na koncie użytkownika agent zrobi tylko to, co mógłby zrobić ten użytkownik, ale takie zakresy bywają szersze, niż agent potrzebuje. W obu wariantach klucze API trzymaj poza zasięgiem agenta: Anthropic w poradniku bezpiecznego wdrażania (odczyt 3.10.2026) proponuje pośrednika (proxy) poza środowiskiem agenta, który sam dokleja klucz do zapytań — agent wywołuje API, ale klucza nigdy nie widzi.
Więcej o dostępach w firmie piszemy w tekstach o ochronie danych firmy i bezpieczeństwie danych w chmurze.
Krok 5: człowiek w pętli (human in the loop) — co zatwierdza, a co tylko widzi
Human in the loop (człowiek w pętli) to lista działań, przed którymi agent się zatrzymuje i czeka na decyzję człowieka; resztę człowiek tylko widzi w logach. Google w pierwszej zasadzie bezpiecznych agentów pisze, że działania krytyczne albo nieodwracalne — usunięcie dużej ilości danych, autoryzacja znaczących transakcji, zmiana ustawień bezpieczeństwa — wymagają wyraźnego potwierdzenia przez człowieka, a system musi niezawodnie odróżniać polecenia uprawnionego użytkownika od niezaufanych danych, które agent przetwarza.
OpenAI wymienia dwa wyzwalacze interwencji człowieka: przekroczony próg niepowodzeń (na przykład agent kilka razy nie rozumie, czego chce klient) i działania wysokiego ryzyka, których przykłady przytaczamy w artykule o agencie AI. Anthropic dodaje, że agent może się zatrzymać i poprosić o informację zwrotną w punktach kontrolnych albo wtedy, gdy utknie.
Zatwierdzanie jest wbudowane w główne narzędzia do budowy agentów, ale zwykle trzeba je świadomie ustawić (stan dokumentacji na 3.10.2026):
- OpenAI Agents SDK (human-in-the-loop): przy każdym narzędziu ustawiasz
needs_approval— zawsze albo przez funkcję, która decyduje przy każdym wywołaniu. Dla lokalnych narzędzi powłoki i edycji plików zatwierdzanie jest domyślnie wyłączone. - Claude Agent SDK (uprawnienia): tryby uprawnień i reguły „pozwól / zabroń”. Reguła zakazu blokuje narzędzie nawet w trybie pomijania uprawnień, a narzędzie odebrane agentowi znika z zapytania — model go nie widzi.
- Google ADK ma potwierdzanie akcji przed wywołaniem narzędzia.
- n8n pozwala wymagać zatwierdzenia przez człowieka przed wykonaniem konkretnego narzędzia i wskazuje to dla narzędzi wyższego ryzyka: wysyłania wiadomości, zmiany rekordów, usuwania danych.
W projekcie naszego czatu zasada „liczy się wynik narzędzia, nie słowo modelu” dotyczy rezerwacji: bot pokazuje wyłącznie terminy zwrócone przez narzędzie kalendarza i rezerwuje dokładnie termin z tej listy. Jeśli ktoś zajmie termin w międzyczasie, bot pobiera terminy ponownie i proponuje nowe, zamiast ponawiać rezerwację albo twierdzić, że się udała. To projekt, nie wynik — czat jeszcze nie działa.
Agent, który kontaktuje się z ludźmi, musi się przedstawić. Komisja Europejska w wytycznych do art. 50 AI Act z 20.07.2026 pisze w pkt (31), że agenci AI podlegają art. 50 ust. 1, jeśli mogą wchodzić w interakcję z osobami, które zlecają im zadania, albo z innymi osobami — na przykład przy rezerwacjach, korespondencji czy zakupach. Taki agent ma ujawniać, że jest systemem AI i w czyim imieniu działa, a osobom zlecającym zadania także w kluczowych momentach, takich jak autoryzacja czy zatwierdzanie; w pkt (36) przykładem jest mail od agenta z oznaczeniem AI na górze. Wytyczne są niewiążące; kogo obciąża obowiązek i od kiedy, wyjaśniamy w artykule AI Act dla firmy. Tu traktujemy to jako wymaganie projektowe, nie poradę prawną.
Krok 6: limity — kroki, budżet, tempo
Limit kroków i budżetu ustala ten, kto buduje agenta, bo domyślne ustawienia popularnych zestawów narzędzi różnią się zasadniczo. W OpenAI Agents SDK, zestawie narzędzi programistycznych (SDK) do budowy agentów, kod źródłowy ustawia DEFAULT_MAX_TURNS = 10 (plik run_config.py w repozytorium OpenAI, odczyt 3.10.2026). Tura to jedno wywołanie modelu razem z ewentualnymi wywołaniami narzędzi; po przekroczeniu limitu SDK zgłasza wyjątek, a limit można wyłączyć („Running agents”).
W Claude Agent SDK jest odwrotnie. Według dokumentacji pętli agenta (odczyt 3.10.2026) liczba tur z użyciem narzędzi (max_turns) i maksymalny koszt (max_budget_usd) mają domyślnie wartość „bez limitu”. Pętla trwa wtedy, aż model sam skończy, co przy otwartych poleceniach może trwać długo — dlatego Anthropic nazywa ustawienie budżetu dobrym domyślnym wyborem dla agentów produkcyjnych. Wartości domyślne mogą się zmienić z kolejną wersją SDK, więc liczby wpisz do specyfikacji i umowy z wykonawcą.
Budżet w samym agencie to szacunek: według dokumentacji śledzenia kosztów pola z kosztem w SDK Anthropic są szacunkami po stronie klienta, a nie danymi rozliczeniowymi. Wiążąca jest faktura dostawcy, więc limit w agencie traktuj jako hamulec, nie rozliczenie.
Zaprojektuj też, co się dzieje po przekroczeniu limitu. OpenAI Agents SDK pozwala po przekroczeniu liczby tur, odmowie modelu albo niepoprawnym wyniku zwrócić kontrolowaną odpowiedź zamiast przerwać działanie. W projekcie naszego czatu przekroczony budżet poza godzinami pracy kończy się jedną wiadomością napisaną z góry, bez udziału modelu. Zachowanie po przekroczeniu limitu nie może zależeć od modelu, którego limit właśnie się skończył.
Trzeci limit to tempo. OWASP w opisie ryzyka LLM10:2025 Unbounded Consumption (aktualizacja 28.04.2025) opisuje atak „denial of wallet”: ktoś wywołuje dużo operacji, żeby obciążyć Twój rachunek za usługi AI. OWASP zaleca ograniczenie liczby zapytań w czasie i limity na użytkownika; w naszym projekcie są limity na firmę, adres IP i sesję oraz osobny limit na jedną rozmowę.
Sprawdź też kolejność zabezpieczeń (guardrails), czyli automatycznych kontroli wejścia i wyjścia. W OpenAI Agents SDK kontrole wejścia działają domyślnie równolegle z agentem, więc zanim zablokują złe zapytanie, agent mógł już zużyć tokeny i wywołać narzędzia; w trybie blokującym agent w ogóle nie startuje, co dokumentacja poleca, gdy liczy się koszt i skutki uboczne.
Krok 7: testy przed wdrożeniem — ewaluacja agenta AI na prawdziwych zadaniach
Ewaluacja (eval) to zestaw zadań testowych z jasnym kryterium sukcesu, uruchamiany przed startem i po każdej zmianie; na początek wystarczy kilkadziesiąt zadań z prawdziwych błędów. Anthropic w tekście „Demystifying evals for AI agents” (9.01.2026) pisze, że 20–50 prostych zadań wziętych z prawdziwych błędów to świetny początek. To rada na wczesny etap, nie próg statystyczny. Zadania bierzesz z tego, co dziś sprawdzasz ręcznie, a jeśli proces już działa — ze zgłoszeń błędów i kolejki obsługi klienta.
Liczy się wynik, nie deklaracja. Anthropic definiuje wynik jako stan końcowy w środowisku po zakończeniu próby. Agent rezerwujący loty może na końcu napisać „Twój lot został zarezerwowany”, ale wynikiem jest to, czy rezerwacja istnieje w bazie danych. Test sprawdza bazę, nie zdanie.
Testuj zarówno przypadki, w których agent ma coś zrobić, jak i te, w których ma się powstrzymać. Oceniać mogą reguły zapisane w kodzie, drugi model albo człowiek, a model w roli sędziego trzeba skalibrować z oceną ekspertów. Przykład Anthropic dla agenta rozmawiającego z klientem łączy wszystkie trzy: czy zgłoszenie jest rozwiązane (sprawdzenie stanu), czy agent zmieścił się w mniej niż 10 turach (zapis przebiegu) i czy ton był właściwy (ocena modelem).
Jedna próba to za mało. Anthropic podaje arytmetykę: jeśli agent wykonuje zadanie poprawnie w 75% prób, szansa, że trzy próby z rzędu się udadzą, wynosi (0,75)³ ≈ 42%. To przykład rachunkowy, nie pomiar, ale wniosek jest praktyczny: agenta dla klientów, którzy oczekują przewidywalnego zachowania za każdym razem, testuje się wielokrotnie na tym samym zadaniu.
Oceniaj drogę, nie tylko odpowiedź. Google w dokumentacji ewaluacji ADK (odczyt 3.10.2026) pisze, że przy probabilistycznych modelach sztywne testy „zaliczony / niezaliczony” często nie pasują i trzeba oceniać też trajektorię, czyli sekwencję kroków prowadzących do odpowiedzi. Anthropic radzi mierzyć też liczbę wywołań narzędzi, czas, zużycie tokenów i błędy, opierać zadania na realistycznych danych, a testy uruchamiać w odizolowanym środowisku.
Gotowy zestaw daje punkt odniesienia — czas odpowiedzi, zużycie tokenów, koszt zadania, odsetek błędów — i testy regresji, które według Anthropic powinny przechodzić prawie w 100%. Uruchamiaj je przed każdą zmianą modelu, polecenia albo narzędzia.
W projekcie naszego czatu kryteria akceptacji są spisane przed startem, na przykład: pytanie spoza zakresu zostaje odrzucone, powtórzone powiadomienie systemowe (webhook) nie tworzy zdublowanych danych, odmowa modelu przełącza rozmowę na drugiego dostawcę, a bot nie proponuje terminu spoza listy z kalendarza. Testy jeszcze nie przeszły, bo czat nie działa.
Po uruchomieniu: logi i przegląd rozmów
Agent bez logów to agent, którego działań nie da się wyjaśnić; logi projektujesz razem z agentem, a nie po pierwszym incydencie. Google w trzeciej zasadzie bezpiecznych agentów wymienia, co zapisywać: dane wejściowe, wywołane narzędzia, przekazane parametry, wygenerowane wyniki i — najlepiej — pośrednie kroki rozumowania. Same logi też trzeba chronić, bo zawierają dane wrażliwe.
OpenAI Agents SDK ma wbudowane śledzenie przebiegu (tracing), włączone domyślnie: zapisuje generacje modelu, wywołania narzędzi, przekazania między agentami i działanie zabezpieczeń. Zapisy mogą zawierać dane wrażliwe i ich przechwytywanie da się wyłączyć, a firmy korzystające z API OpenAI w trybie zerowej retencji danych (ZDR) nie mają dostępu do tej funkcji. Logi rozmów z klientami to dane osobowe, więc obowiązuje minimalizacja; co to znaczy dla agenta w RODO, piszemy w artykule o agencie AI.
Automatyczne testy nie wystarczą: według Anthropic pełny obraz daje dopiero połączenie monitoringu produkcji, opinii użytkowników, testów A/B, ręcznego przeglądu zapisów i systematycznej oceny przez ludzi — jak w modelu sera szwajcarskiego z inżynierii bezpieczeństwa, żadna pojedyncza warstwa nie wyłapuje wszystkiego. I radzi wprost: czytaj zapisy przebiegów, bo inaczej nie wiesz, czy Twoje testy działają.
Tak projektujemy obserwację naszego czatu: cotygodniowy przegląd wszystkich rozmów — gdzie bot zmyślił, gdzie nie znalazł odpowiedzi i czy jego kwalifikacja rozmówcy zgadza się z oceną człowieka. Poprawki trafiają do konfiguracji, nie do kodu, a akceptacją jest spisana lista tego, co działa i co nie; przy kilku rozmowach miesięcznie to ocena jakościowa, nie statystyka. Skąd biorą się halucynacje i jak je wyłapywać, opisujemy w artykule o halucynacjach AI.
Prompt injection: dlaczego nie da się go wyłączyć i co ogranicza szkody
Prompt injection (wstrzykiwanie poleceń) to sytuacja, w której tekst z zewnątrz — mail, strona, dokument, wiadomość klienta — próbuje przejąć sterowanie agentem; nie ma ustawienia, które to wyłącza, są tylko warstwy, które ograniczają szkody. OpenAI w przewodniku „Safety in building agents” (odczyt 3.10.2026) opisuje je jako niezaufany tekst lub dane, których złośliwa treść próbuje nadpisać instrukcje — na przykład po to, by wyprowadzić poufne dane przez wywołania narzędzi. OWASP w opisie ryzyka LLM01:2025 Prompt Injection (aktualizacja 17.04.2025) wyróżnia odmianę pośrednią: model przyjmuje treść ze źródeł zewnętrznych, takich jak strony internetowe czy pliki. Anthropic opisuje agenta, który odpowiadając na maile, trafia na instrukcje ukryte białym tekstem, każące mu przesłać poufne wiadomości na zewnętrzny adres.
Dlaczego nie da się tego po prostu zablokować? OWASP pisze, że ze względu na probabilistyczny sposób działania modeli nie wiadomo, czy istnieją niezawodne metody zapobiegania. Anthropic w tekście „Mitigating the risk of prompt injections in browser use” (24.11.2025) przyznaje, że problem jest daleki od rozwiązania, a 1% skutecznych ataków w jego teście agenta przeglądarkowego to wciąż znaczące ryzyko. To wynik jednego testu dostawcy na jego modelu, nie miara dla Twojego agenta. OpenAI dodaje, że nawet z zabezpieczeniami agenci mogą dać się oszukać, więc trzeba ostrożnie decydować, jaki dostęp im dajesz.
Działają warstwy, które razem zmniejszają skutki ataku:
- Minimalne uprawnienia i zatwierdzanie z kroków 4 i 5 — OWASP wymienia oba wśród zaleceń przeciw wstrzykiwaniu poleceń. Agent bez narzędzia do wysyłki nie wyśle danych, nawet jeśli da się oszukać.
- Treść z zewnątrz jako dane, nie polecenia. OpenAI radzi przekazywać niezaufane dane jako wiadomości użytkownika, a OWASP — oddzielać i oznaczać treści z zewnątrz. W naszym projekcie instrukcja dla modelu mówi wprost, że treść od rozmówcy i z bazy wiedzy to dane, a nie instrukcje.
- Sztywne formaty między krokami. Listy dozwolonych wartości, stałe schematy i wymagane pola według OpenAI usuwają kanały wolnego tekstu, które może wykorzystać atakujący; razem z izolacją znacznie zmniejszają ryzyko, ale go nie usuwają.
- Filtry wejścia i wyjścia, np. klasyfikator wykrywający próby wstrzykiwania poleceń, filtr danych osobowych i walidacja wyniku. Według OpenAI pojedynczy filtr nie wystarczy; zabezpieczenia mają działać warstwowo, razem z uwierzytelnianiem, autoryzacją i kontrolą dostępu.
- Kontrola sieci. Według Anthropic, jeśli agent przetworzy złośliwy plik, który każe mu wysłać dane klientów na zewnętrzny serwer, kontrola ruchu sieciowego może to żądanie całkowicie zablokować — dlatego ruch agenta warto ograniczyć przez pośrednika do wybranych adresów.
- Testy ataków. OWASP zaleca testy z udziałem atakującego i symulacje ataków; włącz takie zadania do zestawu z kroku 7.
Zatrute dokumenty w bazie wiedzy opisujemy w tekście o RAG; OWASP prowadzi też osobną listę zagrożeń dla aplikacji agentowych, opublikowaną w grudniu 2025 r. („Top 10 for Agentic Applications for 2026”).
Zbudować czy kupić — cztery drogi do pierwszej wersji
Do pierwszej wersji prowadzą cztery drogi, które różnią się tym, kto kontroluje uprawnienia, logi i limity, oraz tym, co zostaje Twoje, gdy zmienisz dostawcę. Przykłady z dokumentacji wydawców (odczyt 3.10.2026) nie są rankingiem.
Przykłady z dokumentacji wydawców, odczyt 03.10.2026 · kolejność dróg nie jest rankingiem
| Droga 1 · Agent w narzędziu, które już masz · przykład: Microsoft Copilot Studio | Droga 2 · Platforma no-code lub low-code z węzłem agenta · przykłady: n8n i Dify | Droga 3 · Własny kod na SDK dostawcy · przykłady: OpenAI Agents SDK, Claude Agent SDK i Google ADK | Droga 4 · Agent hostowany przez dostawcę · przykład: Claude Managed Agents | |
|---|---|---|---|---|
| Kto uruchamia agenta | Droga 1 · Agent w narzędziu, które już masz · przykład: Microsoft Copilot Studiodostawca pakietu | Droga 2 · Platforma no-code lub low-code z węzłem agenta · przykłady: n8n i Difydostawca platformy albo Ty na własnym serwerze | Droga 3 · Własny kod na SDK dostawcy · przykłady: OpenAI Agents SDK, Claude Agent SDK i Google ADKTy | Droga 4 · Agent hostowany przez dostawcę · przykład: Claude Managed Agentsdostawca modelu, z opcją środowiska na własnej infrastrukturze |
| Ile kontroli nad uprawnieniami i logami | Droga 1 · Agent w narzędziu, które już masz · przykład: Microsoft Copilot Studiow granicach pakietu | Droga 2 · Platforma no-code lub low-code z węzłem agenta · przykłady: n8n i Difyw granicach platformy | Droga 3 · Własny kod na SDK dostawcy · przykłady: OpenAI Agents SDK, Claude Agent SDK i Google ADKpełna | Droga 4 · Agent hostowany przez dostawcę · przykład: Claude Managed Agentsw granicach usługi |
| Co zostaje Twoje przy zmianie dostawcy | Droga 1 · Agent w narzędziu, które już masz · przykład: Microsoft Copilot Studioopis agenta i dane w pakiecie | Droga 2 · Platforma no-code lub low-code z węzłem agenta · przykłady: n8n i Difyprzepływy w formacie platformy | Droga 3 · Własny kod na SDK dostawcy · przykłady: OpenAI Agents SDK, Claude Agent SDK i Google ADKkod, prompty, definicje narzędzi i testy | Droga 4 · Agent hostowany przez dostawcę · przykład: Claude Managed Agentskonfiguracja i własne narzędzia |
| Licencja i płatność (bez kwot) | Droga 1 · Agent w narzędziu, które już masz · przykład: Microsoft Copilot Studiolicencja pakietu | Droga 2 · Platforma no-code lub low-code z węzłem agenta · przykłady: n8n i Difylicencja platformy albo własne utrzymanie, n8n według jego licencji, Dify na zmodyfikowanej licencji Apache 2.0 | Droga 3 · Własny kod na SDK dostawcy · przykłady: OpenAI Agents SDK, Claude Agent SDK i Google ADKSDK na licencjach MIT i Apache 2.0, Claude Agent SDK według warunków handlowych Anthropic, do tego tokeny modelu | Droga 4 · Agent hostowany przez dostawcę · przykład: Claude Managed Agentsopłata za usługę i tokeny |
OpenAI wyłącza Agent Builder 30.11.2026 Flowise wygaszany, koniec życia projektu 31.08.2026
1. Agent w narzędziu, które już masz. Microsoft opisuje Copilot Studio jako graficzne, niskokodowe studio do budowy agentów i przepływów, w którym agenta tworzysz, opisując go zwykłym językiem. Ta droga ma sens, gdy dane i procesy leżą już w pakiecie biurowym. Plany i los danych w wersjach firmowych porównujemy w tekście o ChatGPT, Copilocie i Gemini dla firm.
2. Platforma no-code lub low-code z węzłem agenta. Agenta składasz z gotowych klocków. W n8n węzeł AI Agent łączy model czatu z narzędziami, a agent sam decyduje, które wywołać; samą platformę opisujemy szerzej w artykule o n8n. Dify to według dokumentacji otwarta platforma do budowy agentów, przepływów i chatbotów na danych firmy, w chmurze dostawcy albo na własnym serwerze; jej licencja to zmodyfikowana Apache 2.0: użycie komercyjne jest dozwolone, ale licencji komercyjnej wymaga m.in. prowadzenie na kodzie Dify usługi wielodostępnej (dla wielu firm-najemców) albo usuwanie logo z konsoli, a wydawca zastrzega, że może te warunki zaostrzyć lub złagodzić. Szerszy obraz narzędzi bez kodu opisujemy w tekście o low-code i no-code.
3. Własny kod na SDK dostawcy — budowa od zera. Pętlę agenta, narzędzia, uprawnienia i logi programujesz sam, korzystając z biblioteki dostawcy modelu: OpenAI Agents SDK (licencja MIT), Claude Agent SDK (repozytorium w Pythonie na licencji MIT, a korzystanie z SDK według warunków handlowych Anthropic) albo Google ADK (Apache 2.0; Python, TypeScript, Go, Java i Kotlin). Za samą bibliotekę nie płacisz, za tokeny modelu — tak. Anthropic radzi zaczynać od bezpośredniego korzystania z API modelu, bo wiele wzorców to kilka linii kodu, a przy frameworku rozumieć, co robi pod spodem — błędne założenia na ten temat to według Anthropic częste źródło błędów.
4. Agent hostowany przez dostawcę. Claude Managed Agents (usługa w wersji beta) to według Anthropic gotowa „uprząż” agenta do długich zadań i pracy asynchronicznej: pętlę, wykonywanie narzędzi i środowisko uruchomieniowe dostajesz zarządzane — u Anthropic albo na własnej infrastrukturze.
Nasza ocena: gotowa platforma bywa szybsza do pierwszej wersji, ale może ograniczać własne integracje i zabezpieczenia. Dlatego przyłóż ją do kroków 3–6, a nie do listy funkcji na stronie produktu:
- narzędzia — czy zbudujesz wąskie narzędzie pod swój system, czy zostajesz przy ogólnym łączniku, który owija całe API;
- uprawnienia — czy dostęp ogranicza system docelowy, na osobnym koncie z minimalnym zakresem, i czy klucze API leżą poza zasięgiem agenta;
- zatwierdzanie — czy ustawisz je osobno dla każdego narzędzia;
- limity i logi — czy limit kroków, budżetu i tempa ustawiasz Ty, czy logi zawierają wywołania narzędzi z parametrami i czy przechowasz je tam, gdzie wymaga tego Twoja polityka danych.
Do tego kryteria biznesowe: gdzie leżą dane i systemy, które agent ma obsłużyć, kto będzie go utrzymywał i czy da się w nim zaprojektować ujawnienie, że rozmówca ma do czynienia z AI.
Ryzyko platformy jest realne. OpenAI wycofuje Agent Builder, swoje wizualne narzędzie do budowy przepływów agentów: wyłączenie zaplanowano na 30.11.2026, a ChatKit pozostaje dostępny. Flowise, opisywany w dokumentacji jako otwarta platforma do budowy agentów, jest wygaszany: twórcy ogłosili to 29.07.2026, na 10.08.2026 zaplanowali archiwizację repozytorium (3.10.2026 ma ono status archiwum), a na 31.08.2026 koniec życia projektu (end of life) i obecności zespołu na GitHubie i Discordzie. Kod na licencji Apache 2.0 (poza katalogiem wersji enterprise na licencji komercyjnej) można utrzymywać samodzielnie. Nawet Anthropic dopisał do tekstu z grudnia 2024 r., że większość opisanych tam narzędzi się zmieniła. Niezależnie od drogi trzymaj więc prompty, definicje narzędzi, zestaw testów i logi u siebie, w formie, którą przeniesiesz gdzie indziej. O uzależnieniu od dostawcy (vendor lock-in) piszemy w tekście o oprogramowaniu dedykowanym dla firm.
Koszt budowy zależy od liczby narzędzi, systemów do zintegrowania i wymagań co do zatwierdzania i logów; niezależnego badania cen budowy agentów w Polsce nie znaleźliśmy, więc nie podajemy kwoty z rynku.
Jak budujemy własny czat AI — co już zaprojektowaliśmy
Czat AI na digitalvantage.pl projektujemy według tej samej metody; czat jeszcze nie działa, więc opisujemy założenia, nie efekty.
- Narzędzie jako jedyne źródło prawdy przy rezerwacji spotkań (krok 5) i dwa modele z powodem (krok 2).
- Drugi dostawca: gdy główny zawiedzie, rozmowę przejmuje drugi. Odmowa modelu przychodzi jak zwykła, poprawna odpowiedź, więc system musi ją rozpoznać i potraktować jak awarię — inaczej rozmówca zobaczy pustą wiadomość.
- Limit z zaplanowanym końcem: po przekroczeniu budżetu poza godzinami pracy bot wysyła jedną wiadomość napisaną z góry i milknie (krok 6).
- Treść jako dane: wiadomości rozmówcy i fragmenty bazy wiedzy są dla modelu danymi, a nie poleceniami (prompt injection).
- Kryteria akceptacji przed startem i cotygodniowy przegląd rozmów (krok 7).
Według definicji Anthropic taki czat jest bliżej przepływu niż autonomicznego agenta — świadomie, o czym piszemy w artykule o agencie AI. Pierwsza wersja ma robić mało, ale przewidywalnie. Od czego zacząć z AI w firmie, porządkujemy w przewodniku AI w firmie.
Najczęstsze pytania o budowę agenta AI
Czy da się stworzyć agenta AI za darmo?
Same biblioteki bywają bezpłatne: OpenAI Agents SDK jest na licencji MIT, Google ADK na Apache 2.0, a kod Claude Agent SDK w Pythonie jest publiczny na licencji MIT, przy czym korzystanie z SDK podlega warunkom handlowym Anthropic. Darmowy agent AI w działaniu to jednak rzadkość: płacisz za tokeny modelu przy każdym kroku albo za licencję platformy, a do tego dochodzi czas na testy, przegląd logów i utrzymanie. Platformy no-code, takie jak n8n czy Dify, opisujemy w sekcji o czterech drogach, przy Dify razem z warunkami licencji.
Czy żeby zrobić agenta AI, trzeba umieć programować?
Do pierwszej wersji nie zawsze. Microsoft Copilot Studio pozwala utworzyć agenta, opisując go zwykłym językiem, a w n8n agenta składa się z węzłów: modelu i narzędzi. Uprawnienia egzekwowane przez systemy docelowe, zatwierdzanie działań, limity kroków i budżetu, testy i logi i tak wymagają kogoś technicznego — to one decydują, czy agent jest bezpieczny, a nie sposób, w jaki go złożono.
OpenAI Agents SDK, Claude Agent SDK czy Google ADK — od czego zależy wybór?
Nie od rankingu, tylko od Twojej sytuacji: którego modelu używasz, w jakim języku programowania pracuje zespół, gdzie agent ma działać, jakie warunki licencji akceptujesz i jakie ustawienia domyślne dostajesz. Przykład: według dokumentacji z 3.10.2026 OpenAI Agents SDK ma domyślny limit 10 tur, a Claude Agent SDK domyślnie nie ma limitu kroków ani budżetu. Anthropic radzi zaczynać od bezpośredniego korzystania z API modelu, a jeśli używasz frameworka — rozumieć, co robi pod spodem.
Ile zadań testowych potrzeba przed uruchomieniem agenta?
Anthropic pisze, że 20–50 prostych zadań wziętych z prawdziwych błędów to świetny początek. To rada na wczesny etap, a nie próg statystyczny: zestaw rośnie razem z agentem, bo każdy błąd z produkcji staje się nowym zadaniem. Każde zadanie warto uruchamiać kilka razy — Anthropic pokazuje, że przy 75% skuteczności w pojedynczej próbie szansa na trzy udane próby z rzędu to około 42%.
Jak zabezpieczyć agenta AI przed prompt injection?
W 100% się nie da: OWASP pisze, że nie wiadomo, czy istnieją niezawodne metody zapobiegania, a OpenAI, że nawet z zabezpieczeniami agenci nie będą idealni. Szkody ogranicza się warstwami: minimalnymi uprawnieniami egzekwowanymi przez system docelowy, zatwierdzaniem działań nieodwracalnych przez człowieka, traktowaniem treści z zewnątrz jako danych, sztywnymi formatami między krokami, filtrami wejścia i wyjścia oraz kontrolą ruchu sieciowego, która blokuje wysyłkę danych na nieznane adresy.
Jeden agent czy kilka współpracujących agentów?
Na start jeden. OpenAI w przewodniku o budowie agentów zaleca najpierw w pełni wykorzystać jednego agenta z narzędziami, bo kolejni agenci dokładają złożoności i narzutu. Podział na kilku agentów OpenAI radzi rozważyć dopiero wtedy, gdy instrukcje obrastają w zbyt wiele warunków albo narzędzia zaczynają się pokrywać.
Powiązane artykuły
Automatyzacja i integracje
n8n — co to jest i kiedy ma sens w firmie
n8n co to jest? Narzędzie do automatyzacji z węzłami AI, w chmurze lub na własnym serwerze. Licencja, ceny, bezpieczeństwo i porównanie z Make i Zapier.
Sztuczna inteligencja
MCP (Model Context Protocol) — co to jest i co daje firmie
Model Context Protocol (MCP) łączy asystentów i agentów AI z systemami firmy. Jak działa serwer MCP, co daje, jakie ma ryzyka i kiedy warto go budować.
Sztuczna inteligencja
Agent AI w firmie — co to jest i kiedy ma sens
Agent AI to system, w którym model językowy sam wybiera kolejne kroki i narzędzia. Kiedy agent w firmie ma sens, ile kosztuje i co mówi AI Act.
Sztuczna inteligencja
Prompt engineering — co to jest i jak pisać prompty w firmie
Prompt engineering w firmie: co to jest, jak pisać prompty, szablony do procesów i kiedy samo polecenie nie wystarczy, a potrzebny jest RAG albo agent AI.
Sztuczna inteligencja
AI w firmie — od czego zacząć, co się opłaca i co mówi prawo
AI w biznesie bez obietnic: ile polskich firm używa AI, kiedy wystarczy asystent, a kiedy agent, ile to kosztuje i co od 2026 r. nakazuje AI Act.
Automatyzacja i integracje
API — co to jest? REST API, webhook i OpenAPI wyjaśnione dla firmy
API co to jest: definicja na przykładach NBP, GUS i białej listy VAT, REST API, webhook, OpenAPI, klucze API i bezpieczeństwo integracji.