
Sztuczna inteligencja16 min czytania3047 słówRedakcja dvnt
Prompt engineering — co to jest i jak pisać prompty w firmie
Prompt engineering w firmie: co to jest, jak pisać prompty, szablony do procesów i kiedy samo polecenie nie wystarczy, a potrzebny jest RAG albo agent AI.
Prompt engineering to pisanie poleceń dla modelu AI tak, żeby powtarzalnie dawał wynik, którego potrzebujesz. Tak definiuje go dokumentacja OpenAI (odczyt 13.10.2026): to proces pisania skutecznych instrukcji, dzięki którym model konsekwentnie tworzy treść spełniającą Twoje wymagania. Najważniejsze jest tu słowo „konsekwentnie”. Jedna udana odpowiedź w czacie niczego nie dowodzi.
W firmie problem wygląda zwykle tak: kilka osób korzysta z tego samego asystenta, a wyniki są nierówne. Jedna dostaje użyteczny szkic oferty, druga ogólnik, trzecia tekst z liczbami, których nie było w materiałach. Różnica rzadko leży w modelu, najczęściej w tym, jak opisano zadanie. Poniżej: jak pisać polecenia do ChatGPT, Copilota czy Gemini, które popularne rady przestały działać, w czym dostawcy modeli sobie przeczą, jak zbudować bibliotekę szablonów i kiedy żadne polecenie nie wystarczy. Rady dostawców zmieniają się z każdą generacją modeli, dlatego podajemy je według dokumentacji odczytanej 13.10.2026.
Prompt engineering — co to jest (i co to jest prompt)
Prompt, po polsku polecenie, to wszystko, co przekazujesz modelowi AI: pytanie, zadanie, materiał do pracy i wskazówki, jak ma wyglądać odpowiedź. Microsoft w polskiej pomocy Copilota (aktualizacja: wrzesień 2026) konsekwentnie pisze „polecenie” i tego słowa używamy dalej zamiennie z „promptem”.
Prompt engineering, czyli inżynieria promptów, to umiejętność pisania i porządkowania takich poleceń. Każdy dostawca nazywa ją trochę inaczej. Google w dokumentacji Gemini API (aktualizacja 17.09.2026) mówi o projektowaniu promptów, które mają wywołać trafne odpowiedzi wysokiej jakości, i dodaje, że to proces iteracyjny: wytyczne są punktem wyjścia, a resztę ustala się, obserwując odpowiedzi modelu. OpenAI zauważa, że skoro model nie odpowiada za każdym razem tak samo, uzyskanie pożądanego wyniku jest „mieszanką sztuki i nauki”.
W firmie prompt engineering ma dwa poziomy:
- pracownik w czacie — ktoś pisze polecenie w ChatGPT, Copilocie albo Gemini, żeby przygotować odpowiedź klientowi, notatkę czy zestawienie;
- polecenie w aplikacji albo agencie — stałe instrukcje (polecenie systemowe), które programista zapisuje w aplikacji korzystającej z modelu. OpenAI zaleca trzymać je w kodzie aplikacji, gdzie każda zmiana przechodzi przegląd kodu i testy.
Ten artykuł dotyczy głównie pierwszego poziomu, ale zasada sprawdzania wyniku jest na obu ta sama. Jak instrukcje działają w agencie, opisujemy w poradniku jak zbudować agenta AI, a czym jest model, który te polecenia czyta, w tekście o dużych modelach językowych (LLM).
Technik pisania promptów jest dziesiątki. Przegląd Schulhoffa i in. z 2024 r. naliczył 58 technik dla modeli tekstowych i zwrócił uwagę na sprzeczną terminologię w tej dziedzinie. Pracownikowi nie jest potrzebny katalog, tylko kilka nawyków i sposób sprawdzenia, czy działają.
Jak pisać prompty: cztery części dobrego polecenia
Dobre polecenie opisuje zadanie tak, jak opisałbyś je nowemu pracownikowi: co ma zrobić, po co, na jakim materiale i jak ma wyglądać wynik. Microsoft ujmuje to w czterech częściach, które w polskiej pomocy Copilota brzmią: Cel (co ma zrobić Copilot), Kontekst (dlaczego jest to potrzebne i kto jest zaangażowany), Źródło (jakich informacji lub próbek ma używać) i Oczekiwania (jak ma odpowiadać). Ta sama pomoc zastrzega, że wymagany jest tylko jasny cel, ale dodaje, że żeby uzyskać pożądany wynik, często trzeba podać więcej.
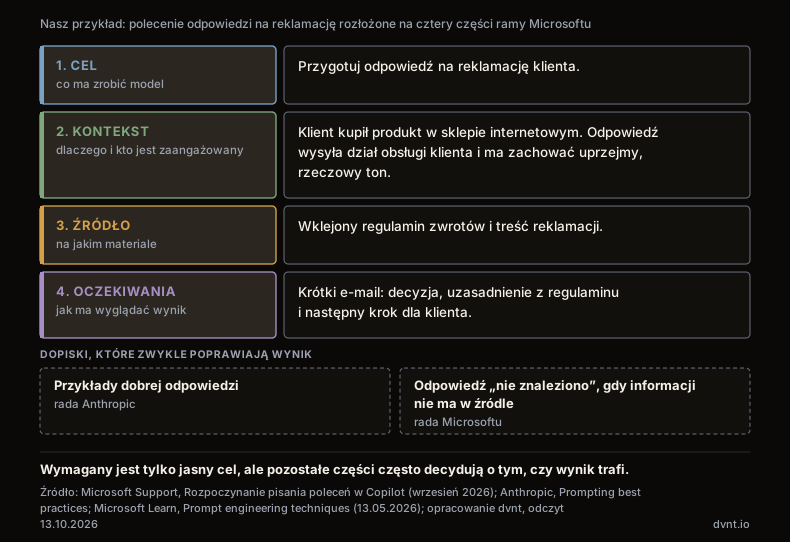
Anthropic w zasadach pisania promptów (odczyt 13.10.2026) mówi to samo innymi słowami: traktuj model jak błyskotliwego, ale nowego pracownika, który nie zna Twoich zwyczajów ani procesów. Im dokładniej opiszesz, czego chcesz, tym lepszy wynik. Do tego „złota reguła”: pokaż polecenie koledze, który nie zna zadania, i poproś, żeby je wykonał. Jeśli on się pogubi, model też się pogubi.
Z dokumentacji dostawców wynika pięć nawyków, które przydają się w każdym zadaniu:
- Uzasadnij, zamiast tylko zakazywać. Anthropic pokazuje to na przykładzie: polecenie „nigdy nie używaj wielokropka” działa gorzej niż wyjaśnienie, że tekst odczyta syntezator mowy, który nie umie wymówić wielokropka. Model, który zna powód, potrafi go uogólnić na przypadki, których nie przewidziałeś.
- Pisz, co robić, a nie czego nie robić. Zamiast „nie używaj punktorów” — „odpowiedz płynnym tekstem w akapitach”. To również rada Anthropic.
- Pokaż przykład. Anthropic nazywa przykłady jednym z najpewniejszych sposobów sterowania formatem, tonem i strukturą odpowiedzi i zaleca trzy do pięciu: bliskich prawdziwemu zadaniu i zróżnicowanych. Oddziel je od instrukcji, na przykład znacznikami. Inni dostawcy widzą przykłady inaczej — o tym niżej.
- Nazwij format wyniku wprost. Tabela z podanymi kolumnami, e-mail do pięciu zdań, lista zadań z osobą i terminem. Model nie zgadnie, że wynik trafi do arkusza.
- Daj prawo do odpowiedzi „nie znaleziono”. Microsoft w opisie technik promptowania (aktualizacja 13.05.2026) radzi przy pytaniach do tekstu dopisać, żeby model odpowiedział „nie znaleziono”, jeśli odpowiedzi w tekście nie ma — to pomaga uniknąć zmyśleń. Dlaczego modele zmyślają i czego polecenie nie naprawi, wyjaśniamy w artykule o halucynacjach AI.
Rozmowa w kilku krokach to norma, a nie porażka. Microsoft pisze wprost, że po pierwszym wyniku najpewniej wyślesz kolejne polecenie, i radzi spodziewać się wymiany zdań. Uprzedza też, że to samo polecenie wpisane kilka razy może dać różne odpowiedzi. Dlatego jeden udany raz nie wystarczy — jak sprawdzać szablon, opisujemy w części o bibliotece poleceń.
Mity: „pomyśl krok po kroku”, „jesteś ekspertem” i grzeczność wobec AI
Trzy najczęściej powtarzane rady — prośba o rozumowanie krok po kroku, rola eksperta i uprzejmość wobec modelu — nie są dziś uniwersalne, a dwie pierwsze podważają sami dostawcy i badacze. Mimo to często podaje się je bez zastrzeżeń.
Chain of thought, czyli „pomyśl krok po kroku”
Technika łańcucha myśli (chain of thought) pochodzi z badania Wei i in. z 2022 r. Autorzy pokazali, że model z 540 mld parametrów, któremu w poleceniu dano osiem przykładów rozpisanego rozumowania, osiągnął najlepszy ówcześnie wynik w zadaniach tekstowych z matematyki (zbiór GSM8K). To wynik na modelach sprzed czterech lat i w zadaniach matematycznych.
Dzisiejsze modele rozumujące myślą same, zanim odpowiedzą, i dostawcy piszą o tym podobnie:
- OpenAI w zaleceniach dla modeli rozumujących (odczyt 13.10.2026): unikaj poleceń typu „chain of thought”, bo prośba „pomyśl krok po kroku” czy „wyjaśnij swoje rozumowanie” jest zbędna, a niektóre techniki mogą nie poprawić wyniku, a czasem go pogorszyć.
- Microsoft zastrzega, że techniki z jego przewodnika nie są zalecane dla modeli rozumujących, a prośbę o rozumowanie krok po kroku opisuje wyłącznie dla modeli bez wbudowanego rozumowania.
- Google pisze, że modele Gemini 2.5 i 3 same generują wewnętrzne „myślenie”, więc zwykle nie trzeba kazać im rozpisywać kroków w odpowiedzi. Przy problemach wymagających dużo rozumowania prosta prośba w rodzaju „pomyśl bardzo dokładnie, zanim odpowiesz” może poprawić wynik, kosztem dodatkowych tokenów.
- Anthropic radzi wybierać ogólne instrukcje zamiast rozpisanych kroków: polecenie „przemyśl to dokładnie” często daje lepsze rozumowanie niż plan napisany ręcznie. Ręczne rozpisywanie rozumowania traktuje jako wyjście awaryjne, gdy wbudowane myślenie jest wyłączone, a przy najnowszych modelach Claude zaznacza, że prośba o wypisanie rozumowania może zostać odrzucona.
Badanie Meincke i in. z czerwca 2025 r. potwierdza to testami: przy modelach zaprojektowanych do rozumowania prośba o łańcuch myśli daje zysk trafności „marginalny, jeśli w ogóle”, a wyraźnie wydłuża czas i zwiększa zużycie tokenów, czyli koszt. Przy zwykłych modelach zwykle trochę pomaga, ale zwiększa rozrzut odpowiedzi i bywa, że psuje odpowiedź na pytanie, na które model odpowiedziałby dobrze.
„Jesteś ekspertem od…”
Rola w poleceniu ustawia ton i perspektywę, ale nie dodaje wiedzy. W raporcie Basila i in. z grudnia 2025 r. sprawdzono sześć modeli na trudnych pytaniach z nauk ścisłych, inżynierii i prawa (zbiory GPQA Diamond i MMLU-Pro). Persona eksperta dopasowana do pytania nie miała istotnego wpływu na wynik, z wyjątkiem jednego modelu, a persony „laika” często obniżały trafność. Autorzy zastrzegają, że mierzyli tylko trafność odpowiedzi — rola może służyć innym celom, na przykład zmianie tonu. Anthropic opisuje to podobnie: rola w poleceniu systemowym ustawia zachowanie i ton.
Wniosek dla firmy: rolę wpisuj, gdy chcesz konkretnego tonu albo adresata („odpowiadasz klientowi sklepu, rzeczowo i uprzejmie”). Nie licz na to, że „jesteś doświadczonym prawnikiem” sprawi, że odpowiedź będzie poprawna prawnie.
Grzeczność, napiwki i groźby
Nie ma formułek, które zawsze działają. Pierwszy raport z tej samej serii (Meincke i in., marzec 2025) pokazał, że uprzejmość wobec modelu czasem poprawia wynik, a czasem go obniża, i że nie da się z góry przewidzieć, które podejście pomoże przy danym pytaniu. Trzeci raport (sierpień 2025) nie znalazł istotnego wpływu obiecywania modelowi napiwku ani grożenia mu. Wszystkie te badania prowadzono na angielskich pytaniach testowych, a nie na zadaniach biurowych po polsku.
Co z tego wynika: nie dopisuj formułek z nawyku i przejrzyj stare polecenia po każdej zmianie modelu. Anthropic podaje przykład: nowsze modele Claude mocniej reagują na polecenie systemowe, więc ostre sformułowania w rodzaju „KRYTYCZNE: MUSISZ użyć tego narzędzia, gdy…”, pisane pod wcześniejsze modele, mogą sprawić, że model będzie sięgał po narzędzie zbyt często. Anthropic radzi je złagodzić do zwykłego „użyj tego narzędzia, gdy…”.
Dostawcy sobie przeczą — dlaczego prompt trzeba sprawdzić na swoim modelu
Rady Anthropic, OpenAI, Google i Microsoftu różnią się w podstawowych sprawach, dlatego jedyna uczciwa zasada brzmi: sprawdź polecenie na modelu, którego używasz. Anthropic pisze to wprost: technikę opisaną dla konkretnego modelu traktuj jako zmierzoną na tym modelu i przed użyciem na innym sprawdź ją ponownie na własnych testach.
Rady z dokumentacji dostawców, stan na 13.10.2026 · kolejność kolumn nie jest rankingiem
| Anthropic | OpenAI | Microsoft | ||
|---|---|---|---|---|
| Przykłady w poleceniu | Anthropictrzy do pięciu przykładów | OpenAIprzy modelach rozumujących najpierw bez przykładów, dodać w razie potrzeby | Googlezawsze dawaj przykłady | Microsoftskuteczne polecenia często opierają się na przykładach |
| „Pomyśl krok po kroku” | Anthropictylko przy wyłączonym myśleniu; nowsze modele mogą odmówić wypisania rozumowania | OpenAIunikać przy modelach rozumujących | Googlezwykle zbędne; przy trudnych problemach „pomyśl bardzo dokładnie” może pomóc | Microsofttylko dla modeli bez rozumowania |
| Kolejność przy długim materiale | Anthropicdokument na górze, pytanie na końcu | OpenAIkontekst zwykle pod koniec polecenia | Googlekontekst najpierw, instrukcje na samym końcu | Microsoftzadanie na początku; sprawdź powtórzenie na końcu |
| Rola | Anthropicustawia zachowanie i ton | OpenAIsekcja „tożsamość” w wiadomości dewelopera | Googlepersona w instrukcji systemowej albo na początku polecenia | Microsoftbrak takiej rady w przewodniku (stan na 13.10.2026) |
WNIOSEKBadanie z 2023 r. (Sclar i in.): sama zmiana formatu polecenia zmieniała trafność nawet o 76 punktów procentowych na jednym otwartym modelu, a format dobry dla jednego modelu słabo przewidywał wynik na innym.
Przykłady w poleceniu. Few shot prompting to podanie modelowi kilku przykładów „wejście → oczekiwany wynik”, zero shot — polecenie bez przykładów. Google zaleca, żeby przykłady były w poleceniu zawsze, bo polecenia bez nich są według niego zwykle mniej skuteczne, choć przy zbyt wielu przykładach model zaczyna zbyt ściśle się do nich dopasowywać. Microsoft pisze, że skuteczne polecenia często opierają się na jednym lub kilku przykładach. OpenAI przy modelach rozumujących radzi odwrotnie: zacznij bez przykładów, dodaj je, jeśli wynik ma spełniać złożone wymagania — i pilnuj, żeby były zgodne z instrukcją, bo rozbieżność daje słabe wyniki.
Gdzie umieścić polecenie przy długim dokumencie. Microsoft pisze, że według jego badań podanie zadania na początku, przed kontekstem i przykładami, może poprawić jakość wyniku — choć zaznacza, że przy modelach GPT-4 jego testy nie wykazały różnicy. Radzi też sprawdzić, czy nie pomaga powtórzenie instrukcji na końcu, bo modele bywają podatne na efekt świeżości: to, co stoi na końcu polecenia, może mocniej wpływać na wynik niż to, co na początku. Anthropic przy dokumentach od ok. 20 tys. tokenów (token to fragment słowa, w którym model liczy tekst) zaleca dokument na górze, a pytanie na końcu. Podaje, że w jego testach poprawiało to jakość odpowiedzi nawet o 30%, zwłaszcza przy kilku dokumentach naraz — to liczba samego dostawcy, bez opisu testu. Google przy Gemini 3 każe dać cały kontekst najpierw, a konkretne instrukcje na samym końcu. OpenAI pisze, że kontekst zwykle najlepiej umieścić pod koniec polecenia.
Dlaczego to ma znaczenie. Badanie Sclara i in. z 2023 r. pokazało, że otwarte modele są bardzo wrażliwe na drobne zmiany formatowania polecenia: w skrajnym przypadku, na jednym modelu (LLaMA-2-13B) i z przykładami w poleceniu, sama zmiana formatu zmieniała trafność nawet o 76 punktów procentowych. Ważniejsze jest drugie ustalenie: format, który działał dobrze na jednym modelu, tylko słabo przewidywał wynik na innym. Dzisiejsze modele są nowsze, ale dostawcy mówią to samo. Microsoft: nawet dobrze napisane polecenie, które zadziałało w jednym scenariuszu, nie musi się sprawdzić szerzej. OpenAI: różne modele — a nawet różne wersje modelu z tej samej rodziny — mogą dawać różne wyniki na tym samym poleceniu.
Praktycznie: polecenie skopiowane z poradnika napisanego pod inny model to hipoteza, a nie gotowe rozwiązanie. Jak ją sprawdzić bez programisty, opisujemy w części o bibliotece poleceń.
Prompty do ChatGPT, Copilota i Gemini — szablony do procesów w firmie
Dobry szablon polecenia opisuje Twój proces i każe wkleić Twoje źródło. Nie zawiera wiedzy, której model nie ma. Poniżej pięć szablonów do typowych zadań biurowych. To nasze przykłady, zbudowane na ramie Microsoftu (cel, kontekst, źródło, oczekiwania) i na radach Anthropic o przykładach i uzasadnieniu — nie „najlepsze prompty” i nie obietnica wyniku. Zadziałają w ChatGPT, Copilocie i Gemini, ale każdy trzeba sprawdzić na swoim narzędziu, z powodów opisanych wyżej.
Wspólna zasada: cennik, regulamin, dane klienta i ustalenia wklejasz albo dołączasz jako plik. Nie każesz modelowi ich „pamiętać” ani „znać”. OpenAI zauważa, że dodawanie do zapytania potrzebnego kontekstu bywa nazywane RAG (retrieval-augmented generation) — o tym więcej w części o granicach polecenia.
W piątym szablonie dokument stoi na górze, a polecenie na końcu, zgodnie z radą Anthropic i Google dla długich materiałów. Sprawdź też wariant odwrotny, z zadaniem na początku, który zaleca przewodnik Microsoftu. Cytat przy każdej tezie pozwala sprawdzić streszczenie w minutę, zamiast mu wierzyć.
Gotowe prompty z internetu traktuj jak szablony do przerobienia. Szablon staje się użyteczny dopiero wtedy, gdy ma Twoje źródło, Twój format wyniku i ktoś sprawdził go na Twoich zadaniach.
Biblioteka promptów w firmie: właściciel, wersja, test
Szablon, który ma działać w zespole, potrzebuje właściciela, opisanego kryterium dobrego wyniku i testu powtarzanego po każdej zmianie modelu. Anthropic stawia to jako warunek wstępny: przewodnik po prompt engineeringu (odczyt 13.10.2026) zakłada, że zanim zaczniesz poprawiać polecenie, masz jasno określone kryteria sukcesu i sposób ich sprawdzania. Jeśli nie masz — zacznij od tego.
Miejsce na wspólne szablony zwykle jest już w narzędziu, z którego firma korzysta. Microsoft opisuje Galerię poleceń Copilota (odczyt 13.10.2026): obok poleceń przygotowanych przez Microsoft są w niej polecenia zapisane przez użytkowników i przez zespoły, a dzielenie się nimi ma służyć spójności i współpracy. Zbiory pozostają w granicach dzierżawy firmy (tenant), a administrator widzi w raportach, które polecenia użytkownicy zapisują, lubią i udostępniają. Czy Twój plan daje taką funkcję i jakie odpowiedniki mają ChatGPT i Gemini, sprawdzisz w porównaniu ChatGPT Business, Copilota i Gemini dla firmy.
Narzędzie to jednak mniejsza część pracy. Nasza lista — co powinien mieć każdy szablon w bibliotece:
- nazwę i proces, którego dotyczy (reklamacje, oferty, zestawienia zamówień);
- właściciela — osobę, która odpowiada za treść szablonu i decyduje o zmianach;
- datę i model, na którym szablon sprawdzono;
- 5–10 przykładowych wejść z oczekiwanym wynikiem, w tym przypadki trudne: brak danych, sprzeczne informacje, pytanie spoza źródła;
- kryterium dobrego wyniku spisane przed testem, na przykład „nie zmyśla cen”, „ma termin, jeśli padł”, „mieści się w limicie długości”;
- datę ponownego testu — obowiązkowo po każdej zmianie modelu w narzędziu.
Test nie wymaga programisty. Wklejasz przygotowane przykłady jeden po drugim i odhaczasz kryteria. Jeśli szablon zawodzi w trudnych przypadkach, poprawiasz go, zanim trafi do zespołu, a nie po pierwszej reklamacji.
W aplikacjach, gdzie polecenia piszą programiści, OpenAI zaleca to samo w bardziej formalnej postaci: przypinać aplikację do konkretnej wersji modelu, budować testy mierzące zachowanie polecenia przy każdej zmianie wersji i przechowywać polecenia w kodzie aplikacji, gdzie przechodzą przegląd jak każda inna zmiana. Zmieniają się nawet narzędzia do przechowywania promptów: OpenAI wycofuje z API zapisane obiekty promptów, a usługa v1/prompts ma zostać wyłączona 30.11.2026. Dotyczy to programistów korzystających z API, nie użytkowników ChatGPT.
Jedno ostrzeżenie dla szablonów, do których wkleja się cudzą treść — e-mail klienta, stronę internetową, dokument od kontrahenta. Taka treść może zawierać ukryte polecenia, które model odczyta jak Twoje (prompt injection). W czacie skutki są ograniczone do odpowiedzi, którą i tak czytasz. W agencie, który ma dostęp do systemów, mogą być poważne — piszemy o tym w poradniku jak zbudować agenta AI.
Kiedy prompt nie wystarczy: RAG, automatyzacja albo agent
Gdy zadanie wymaga wiedzy firmy, obliczeń, codziennego przenoszenia danych między systemami albo decyzji i działań w systemach, lepsze polecenie nie pomoże — potrzebne jest inne rozwiązanie. Anthropic pisze w przewodniku, że nie każde kryterium sukcesu i nie każdy nieudany test najlepiej rozwiązuje się prompt engineeringiem — opóźnienie i koszt czasem łatwiej poprawić, wybierając inny model.
Anthropic nazywa następny krok context engineering. W artykule z 29.09.2025 uznaje go za naturalną kontynuację prompt engineeringu: chodzi już nie tylko o słowa polecenia, ale o cały zestaw informacji, który trafia do modelu w trakcie pracy, łącznie ze wszystkim, co znajduje się tam poza samym poleceniem. Pytanie zmienia się z „jakimi słowami to napisać?” na „jaki kontekst najpewniej da pożądane zachowanie modelu?”. Ten sam tekst ostrzega przed dwiema skrajnościami: poleceniem z kruchą, rozbudowaną logiką zapisaną na sztywno i poleceniem zbyt ogólnym, które fałszywie zakłada, że model zna kontekst.
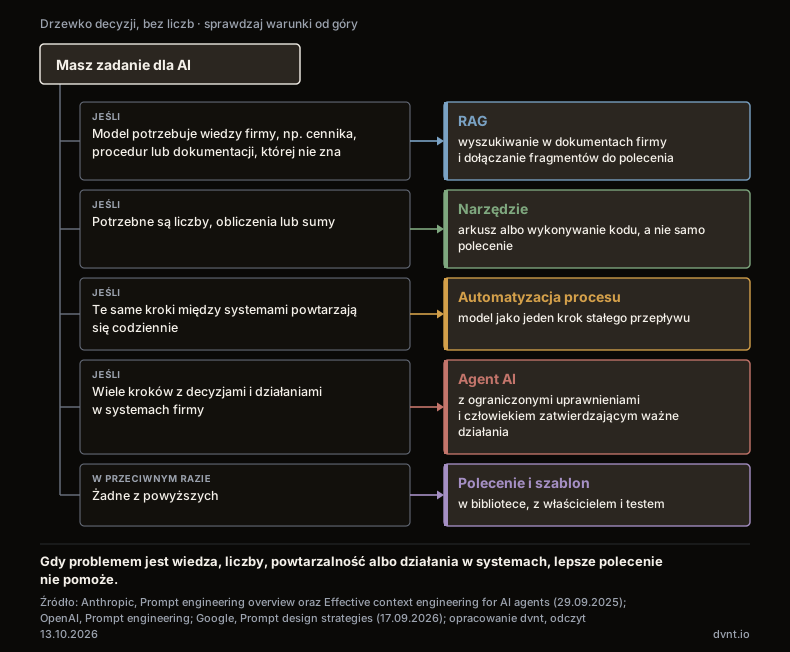
Cztery granice, które widać w praktyce:
- Model nie zna wiedzy firmy. Jeśli pracownicy za każdym razem wklejają ten sam cennik, regulamin albo procedurę — albo, co gorsze, nie wklejają i model zgaduje — to sygnał, że potrzebny jest RAG: system, który sam wyszukuje właściwe fragmenty dokumentów firmy i dołącza je do polecenia. Kiedy wystarczy cały dokument w poleceniu, a kiedy potrzebny jest RAG, opisujemy w artykule o RAG.
- Zadanie wymaga obliczeń. Google radzi włączać wykonywanie kodu zawsze, gdy model ma cokolwiek liczyć, sumować albo przeliczać, a wyszukiwanie w sieci — gdy potrzebuje mało znanych albo świeżych faktów. Żadne polecenie nie zamieni modelu językowego w kalkulator. Sumy w ofercie licz w arkuszu albo narzędziem, nie w czacie.
- Te same kroki między systemami, codziennie. Jeśli pracownik kopiuje dane z poczty do polecenia, a wynik do CRM-u, i robi to dziesiątki razy, problemem nie jest prompt, tylko ręczne przenoszenie danych. To zadanie dla automatyzacji procesu, na przykład w n8n, gdzie model jest jednym z kroków stałego przepływu.
- Wiele kroków z decyzjami i działaniami w systemach. Gdy AI ma sama ustalić kolejne kroki i coś zrobić w systemach — wysłać, zmienić, zamówić — potrzebny jest agent z ograniczonymi uprawnieniami i człowiekiem zatwierdzającym ważne działania. Kiedy agent ma sens, a kiedy wystarczy prostsze rozwiązanie, opisujemy w artykule o agencie AI w firmie.
W tym miejscu firma zwykle potrzebuje już nie lepszego polecenia, tylko wdrożenia: połączenia modelu z dokumentami, systemami i uprawnieniami. Polecenia nadal są jego częścią, ale stają się instrukcjami w aplikacji — wersjonowanymi i testowanymi jak kod.
Prompty a zasady dla pracowników
Pisanie poleceń to umiejętność, ale to, co wolno do nich wkleić, ustala firma, a nie pracownik. Które konta są firmowe, jakie dane wolno wpisywać i czego nie wolno, omawiamy w części „Zasady dla pracowników” w porównaniu ChatGPT Business, Copilota i Gemini dla firmy.
Druga zasada: wynik sprawdza człowiek. Microsoft w pomocy Copilota uprzedza, że odpowiedzi mogą czasem zawierać nieprawdziwe treści, i radzi oceniać je oraz porównywać z zaufanymi źródłami. Dobre polecenie zmniejsza liczbę błędów, ale ich nie zeruje.
AI Act w art. 4, w brzmieniu nadanym rozporządzeniem 2026/1744 z lipca 2026 r., wymaga od firmy, która używa AI, podejmowania środków wspierających rozwój kompetencji pracowników w zakresie AI. Nie wymaga osiągnięcia określonego poziomu i nie nakazuje konkretnego szkolenia z pisania promptów — jak czytać ten przepis, wyjaśniamy w artykule o AI Act dla firmy. Biblioteka szablonów z opisanymi zasadami i testami to jeden z praktycznych sposobów, żeby te kompetencje w zespole w ogóle powstały.
Brak wiedzy to dziś główna bariera. Według GUS w 2025 r. 3,9% firm zatrudniających co najmniej 10 osób rozważało AI, ale z niej nie korzystało, a najczęstszym powodem był brak zasobów ludzkich lub wiedzy (2,4% wszystkich takich firm). W całej Unii, według Eurostatu, brak odpowiedniej wiedzy wskazało 70,89% firm, które kiedykolwiek rozważały AI i z niej nie korzystają. Obie instytucje liczą inaczej, więc tych liczb nie porównujemy — wskazują jednak ten sam problem. Od czego zacząć, piszemy w przewodniku AI w firmie.
Najczęstsze pytania o prompt engineering
Czy firma potrzebuje prompt engineera?
W małej i średniej firmie zwykle nie potrzeba do tego osobnego etatu — to nasza ocena. Potrzebny jest właściciel biblioteki szablonów, który pilnuje, żeby każdy szablon miał kryterium dobrego wyniku i był sprawdzany po zmianie modelu. Polecenia w aplikacjach i agentach pisze zespół, który je wdraża: OpenAI zaleca trzymać je w kodzie, z przeglądem i testami.
Czy warto kupić kurs prompt engineeringu?
Najpierw przeczytaj bezpłatne dokumentacje dostawców — Google i Microsoft mają je także po polsku. Jeśli kupujesz kurs, sprawdź jego datę i to, na jakich modelach uczy: sam Anthropic pisze, że jego samouczek powstał dla modeli Claude 3 i tam, gdzie się różni, należy kierować się nowszymi zasadami. Kurs, który uczy dopisywania „pomyśl krok po kroku” do każdego polecenia, uczy rady, której OpenAI przy modelach rozumujących każe unikać.
Czy ten sam prompt zadziała w ChatGPT, Copilocie i Gemini?
Nie musi. Dostawcy dają sprzeczne rady co do przykładów i kolejności polecenia, a badanie z 2023 r. pokazało, że format dobry dla jednego modelu słabo przewiduje wynik na innym. Sprawdź szablon na każdym narzędziu, którego używa Twój zespół.
Co to jest prompt systemowy (system prompt)?
To stałe instrukcje, które aplikacja przekazuje modelowi obok wiadomości użytkownika: rola, ton, zasady, format. OpenAI pisze, że instrukcje podane w ten sposób mają pierwszeństwo przed poleceniem użytkownika. W czatach odpowiednikiem są instrukcje niestandardowe albo ustawienia projektu, w agentach — instrukcje, które pisze zespół wdrożeniowy i testuje jak kod.
Czy pisać prompty po polsku, czy po angielsku?
Nie znaleźliśmy wiarygodnych danych, które rozstrzygałyby to dla dzisiejszych modeli i zadań biurowych. Badania technik promptowania, które cytujemy, prowadzono po angielsku. Jeśli wynik ma być po polsku i materiał jest po polsku, zacznij od polskiego polecenia i porównaj oba warianty na kilku swoich przykładach.
Czy grzeczność, napiwek albo groźba poprawiają odpowiedzi AI?
Nie ma na to reguły. W badaniach Meincke i in. z 2025 r. uprzejmość raz poprawiała, a raz pogarszała wynik, a obiecywanie napiwku i grożenie modelowi nie miały istotnego wpływu. Testy prowadzono po angielsku. Więcej da dobrze opisane zadanie i źródło niż jakakolwiek formułka.
Powiązane artykuły
Sztuczna inteligencja
MCP (Model Context Protocol) — co to jest i co daje firmie
Model Context Protocol (MCP) łączy asystentów i agentów AI z systemami firmy. Jak działa serwer MCP, co daje, jakie ma ryzyka i kiedy warto go budować.
Automatyzacja i integracje
n8n — co to jest i kiedy ma sens w firmie
n8n co to jest? Narzędzie do automatyzacji z węzłami AI, w chmurze lub na własnym serwerze. Licencja, ceny, bezpieczeństwo i porównanie z Make i Zapier.
Sztuczna inteligencja
Jak stworzyć agenta AI w firmie — od procesu do pierwszej działającej wersji
Jak stworzyć agenta AI w firmie krok po kroku: proces, narzędzia i uprawnienia, człowiek w pętli, limity kosztu, testy i ochrona przed prompt injection.
Sztuczna inteligencja
Agent AI w firmie — co to jest i kiedy ma sens
Agent AI to system, w którym model językowy sam wybiera kolejne kroki i narzędzia. Kiedy agent w firmie ma sens, ile kosztuje i co mówi AI Act.
Sztuczna inteligencja
AI w firmie — od czego zacząć, co się opłaca i co mówi prawo
AI w biznesie bez obietnic: ile polskich firm używa AI, kiedy wystarczy asystent, a kiedy agent, ile to kosztuje i co od 2026 r. nakazuje AI Act.
CRM, ERP i systemy firmowe
Integracja z KSeF — API KSeF dla firmy z własnym systemem: trzy drogi i jak wybrać
API KSeF dla firmy z własnym systemem: program księgowy jako brama, gotowy łącznik albo własna integracja. Co obsłużyć, co deklarują moduły i jak wybrać.
Gdzie AI naprawdę się u Was opłaci?
Opowiedzcie, które zadania zabierają Wam dziś najwięcej czasu. Sprawdzimy, czy wystarczy gotowy asystent, czy potrzebne jest wdrożenie na Waszych danych. Jeśli wystarczy ChatGPT w planie firmowym — powiemy to wprost.