
Sztuczna inteligencja15 min czytania2847 słówRedakcja dvnt
Lokalne AI w firmie — własny serwer, chmura w UE czy API? Koszty, prawo i jakość
Lokalne AI w firmie: kiedy własny serwer albo chmura w UE mają sens, ile kosztuje GPU wobec API, co zmienia region UE i które modele open-weight wolno użyć.
Lokalne AI to model językowy uruchomiony na serwerze, nad którym masz kontrolę — w Twojej firmie albo u europejskiego dostawcy — tak, żeby umowy, wyceny i dokumentacja techniczna nie trafiały do dostawcy modelu ani pod obcą jurysdykcję. Ma sens wtedy, gdy chronisz informacje, na których stoi firma, a nie wtedy, gdy chcesz zaoszczędzić na tokenach. W firmie zatrudniającej kilkadziesiąt osób API dużego dostawcy zwykle wychodzi taniej niż serwer z kartą graficzną, a najlepsze modele i tak są zamknięte. Dlatego najczęściej wygrywa hybryda: najcenniejsze dane idą do modelu u Ciebie albo u dostawcy z UE, reszta — do modelu w chmurze z umową powierzenia i regionem UE.
Ten tekst jest dla właściciela firmy, który nie chce wklejać do czatu umów ani danych klientów i pyta, czy da się mieć AI „u siebie”, ile to kosztuje i czy nie będzie gorsze. Ceny, licencje i dokumentacja dostawców: odczyt 28.10.2026. Szerszą mapę decyzji o sztucznej inteligencji w firmie znajdziesz w przewodniku AI w firmie.
Lokalne AI — co to znaczy: cztery poziomy kontroli nad danymi
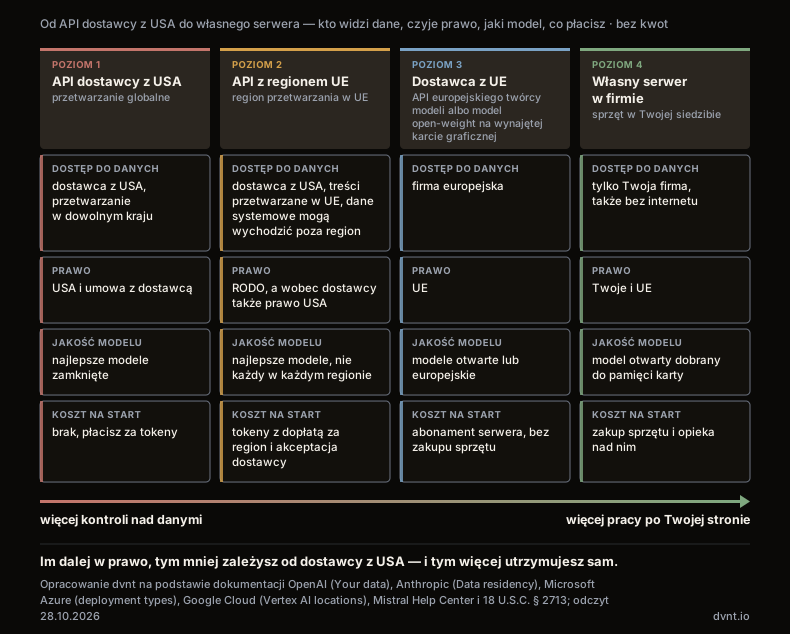
„Lokalne AI” to nie jeden produkt, tylko koniec skali: im bliżej niego jesteś, tym mniej firm i państw może sięgnąć po Twoje dane — i tym więcej pracy spada na Ciebie. Lokalny model AI, nazywany też lokalnym LLM, to model językowy o publicznie dostępnych wagach (open-weight), uruchomiony na infrastrukturze, którą kontrolujesz. Zapytania i dokumenty nie trafiają do twórcy modelu, bo twórca w ogóle nie bierze udziału w ich przetwarzaniu.
Poziomy wyglądają tak:
- API dostawcy z USA, przetwarzanie globalne. Tak działa domyślnie większość integracji. Anthropic w dokumentacji rezydencji danych opisuje ustawienie domyślne „global”: przetwarzanie może się odbywać w dowolnej dostępnej lokalizacji.
- API z regionem UE. OpenAI oferuje region „Europe (EEA + Switzerland)”, ale według dokumentacji trzeba o niego wystąpić do działu sprzedaży, przejść akceptację i zapłacić 10% więcej za modele wydane od 5 marca 2026 r.; dane systemowe — konto, metadane, dane o użyciu — mogą być przetwarzane poza regionem. API Anthropic pierwszej ręki regionu UE nie ma: dostępne są tylko „us” i „global”. Claude w UE jest dostępny przez platformy partnerów: Google Cloud ma dla niego wielo-region „eu” (i region Vertex AI w Warszawie dla innych modeli), Amazon Bedrock — profile przypisane do UE. Microsoft oferuje w Azure wdrożenia Data Zone, w których usługa przetwarza dane tylko w strefie US, EU albo APAC. Dostępność konkretnego modelu w regionie sprawdź w dokumentacji.
- Dostawca z UE. Albo API europejskiego twórcy modeli — Mistral pisze, że dane domyślnie są przechowywane w UE, chyba że świadomie użyjesz punktu w USA — albo model open-weight na karcie graficznej wynajętej u firmy z Europy: OVHcloud, niemieckiego Hetznera czy CloudFerro z regionami w Warszawie.
- Własny serwer w firmie, także odcięty od internetu.
Hobbystyczne „AI lokalnie na laptopie” to poziom czwarty w miniaturze: programy takie jak Ollama czy LM Studio uruchamiają mały model na komputerze. To dobry sposób na pierwszą próbę, ale nie na usługę dla całej firmy: laptop nie obsłuży kilkudziesięciu osób naraz. Warunki LM Studio pozwalają przy tym na użytek osobisty i wewnętrzny w firmie.
Czy ChatGPT jest bezpieczny dla danych firmy?
To zależy od konta i umowy, a nie od marki: firmowe API i plany biznesowe działają na innych zasadach niż prywatne konto pracownika. Przy API OpenAI pisze, że od 1 marca 2023 r. dane przesłane do API nie służą do trenowania ani ulepszania modeli, chyba że wyrazisz na to zgodę, a logi do wykrywania nadużyć przechowuje do 30 dni. Anthropic usuwa wejścia i wyjścia API w ciągu 30 dni, z wyjątkami — przechowuje je do 2 lat, gdy automatyczne systemy oznaczą rozmowę jako naruszającą zasady użytkowania. Jeśli pracownicy potrzebują czatu do pisania i streszczania, plan firmowy z jasnymi zasadami zwykle rozwiązuje problem bez własnego serwera — warunki danych w planach ChatGPT, Copilota i Gemini opisujemy w porównaniu planów firmowych.
Prawdziwe ryzyko leży gdzie indziej: w prywatnych kontach, których firma nie kontroluje. Według Economist Korea z 30.03.2023 w niecałe 20 dni od dopuszczenia ChatGPT w dziale półprzewodników doszło do trzech wycieków. Jeden pracownik skopiował do czatu cały kod źródłowy programu, w którym szukał błędu, drugi wkleił kod do optymalizacji, trzeci — zapis spotkania, z którego chciał zrobić protokół. Firma ograniczyła rozmiar pytań i, co ważniejsze, zaczęła rozważać budowę własnej, wewnętrznej usługi AI.
Według raportu Cyberhaven 2026 39,7% interakcji z narzędziami AI zawiera dane wrażliwe — to raport dostawcy systemów ochrony przed wyciekiem, z danych 222 firm i z własną definicją „wrażliwości”.
Bezpieczeństwo AI w polskich firmach zaczyna się od świadomości. UODO podaje, że w badaniu Społecznego Zespołu Ekspertów przy Prezesie UODO 95,9% podmiotów nie uważa się za przygotowane do wdrożenia AI zgodnie z RODO, a pytanie o zgodność „pada zwykle wtedy, gdy narzędzie już działa”. Kolejność jest więc taka: najpierw zasady dla pracowników i plan firmowy, potem pytanie o własną infrastrukturę.
Region UE to nie suwerenność cyfrowa: dostawca AI z USA i CLOUD Act
Region UE decyduje o tym, gdzie leżą dane; o tym, czyje prawo może po nie sięgnąć, decyduje siedziba dostawcy. Amerykański CLOUD Act z 2018 r. dodał do kodeksu 18 U.S.C. § 2713. Przepis każe dostawcy usług komunikacji elektronicznej lub przetwarzania danych zabezpieczyć, zarchiwizować albo ujawnić dane klienta w swoim „posiadaniu, pieczy lub kontroli”, niezależnie od tego, czy dane znajdują się w USA, czy poza nimi (tłumaczenie własne). To obowiązek uruchamiany nakazem lub wezwaniem wydanym na podstawie tych przepisów, a nie swobodny dostęp do wszystkiego.
Jak wygląda to w praktyce, pokazało przesłuchanie we francuskim Senacie 10.06.2025. Zapytany pod przysięgą, czy może zagwarantować, że dane obywateli powierzone Microsoftowi nie zostaną przekazane na polecenie rządu USA bez zgody władz francuskich, dyrektor ds. publicznych i prawnych Microsoft France Anton Carniaux odpowiedział: „Nie, nie mogę tego zagwarantować, ale, powtarzam, to się jeszcze nigdy nie zdarzyło” (sprawozdanie komisji Senatu, tłumaczenie własne). Chwilę wcześniej powiedział: „Kiedy jesteśmy zobowiązani je przekazać, przekazujemy je”, dodając, że nie dotyczyło to dotąd żadnej europejskiej firmy wśród klientów. Ryzyko jest więc realne, ale nie codzienne.
Przekazywanie danych osobowych do USA pozostaje legalne. Sąd UE 3.09.2025 oddalił skargę na decyzję Komisji z 10.07.2023 o ramach EU-US Data Privacy Framework. Według kancelarii WilmerHale skarżący wniósł 31.10.2025 odwołanie do Trybunału Sprawiedliwości. Trybunał dwa razy unieważniał już poprzednie decyzje o USA (Schrems I w 2015 r., Schrems II w 2020 r.). Lokalizację serwera w RODO i CLOUD Act wobec art. 48 RODO opisujemy w tekście hosting w Polsce czy w UE, historię ram transferowych — w artykule o bezpieczeństwie danych w chmurze.
Dla danych osobowych klientów umowa powierzenia i region UE u dużego dostawcy zwykle wystarczają. Dla informacji, na których stoi firma — receptur, wycen przetargowych, kodu, strategii — liczy się jurysdykcja dostawcy, czyli poziom trzeci albo czwarty.
Prawo: RODO, tajemnica przedsiębiorstwa i AI Act przy lokalnym AI
Lokalny model nie zwalnia z RODO ani z AI Act — zmienia tylko listę firm, którym powierzasz dane. Dostawca modelu w chmurze jest dla Ciebie podmiotem przetwarzającym: art. 28 RODO wymaga umowy i dostawcy, który zapewnia „wystarczające gwarancje” odpowiednich środków technicznych i organizacyjnych, a transfer poza Europejski Obszar Gospodarczy — podstawy z rozdziału V, na przykład zabezpieczeń z art. 46. Przy modelu na własnym serwerze tej pozycji nie ma, ale obowiązki administratora zostają.
Mniej oczywista jest tajemnica przedsiębiorstwa. Ustawa o zwalczaniu nieuczciwej konkurencji w art. 11 ust. 2 uznaje informację za tajemnicę tylko wtedy, gdy uprawniony „podjął, przy zachowaniu należytej staranności, działania w celu utrzymania ich w poufności” (tekst jednolity, Dz.U. 2026 poz. 85). Nasza interpretacja, nie porada prawna: jeśli pracownicy bez żadnych zasad wklejają wyceny do prywatnych czatów, w sporze trudniej wykazać tę staranność; spisane zasady i narzędzie pod kontrolą firmy ją wzmacniają.
Trzecia sprawa to dotrenowywanie. Europejska Rada Ochrony Danych w opinii 28/2024 pisze, że model można uznać za anonimowy tylko wtedy, gdy zidentyfikowanie osób, na których danych go trenowano, i wydobycie z niego tych danych zapytaniami są bardzo mało prawdopodobne. Model dotrenowany na danych osobowych może więc sam je zawierać, a z wag nie usuniesz ich tak jak rekordu z bazy. Dlatego do odpowiedzi na podstawie dokumentów firmy lepiej służy RAG: model dostaje fragmenty z bazy, z której dane usuniesz jednym poleceniem.
AI Act: firma, która uruchamia gotowy model u siebie, jest co do zasady podmiotem stosującym (art. 3 pkt 4), a nie dostawcą modelu ogólnego przeznaczenia. Nawet dostrajanie zwykle tego nie zmienia — według wytycznych Komisji orientacyjny próg to modyfikacja zużywająca ponad jedną trzecią mocy obliczeniowej pierwotnego treningu, a takich modyfikacji jest dziś niewiele. Obowiązki dla zastosowań wysokiego ryzyka, na przykład w rekrutacji, obowiązują niezależnie od tego, gdzie stoi model. Role, terminy i kary opisujemy w tekście o AI Act.
Modele open-weight w 2026: które wolno uruchomić w firmie z UE
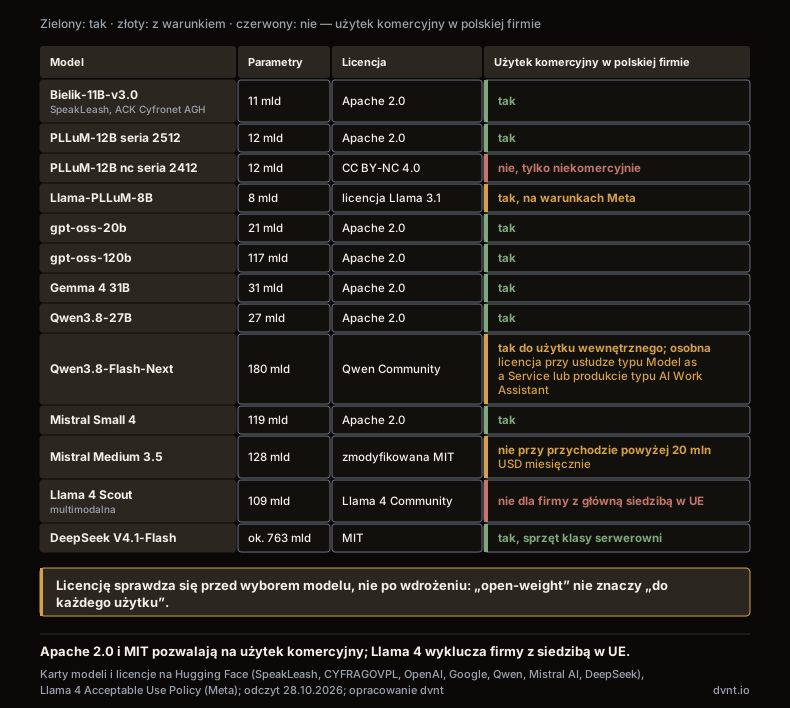
„Open” nie znaczy „wolno wszystko”: przed wyborem modelu przeczytaj licencję konkretnej wersji, bo w tej samej rodzinie warunki potrafią się różnić. Większość modeli z macierzy niżej ma licencję Apache 2.0, pozwalającą na użytek komercyjny. Pułapki są cztery.
- Multimodalna Llama 4. Zasady użytkowania Llama 4 mówią wprost, że prawa z licencji do modeli multimodalnych nie są przyznawane firmie z główną siedzibą w Unii Europejskiej. Ograniczenie nie dotyczy użytkowników końcowych gotowego produktu, ale polska firma nie może takiego modelu sama uruchomić.
- Mistral Medium 3.5. Zmodyfikowana licencja MIT wyłącza firmy, których skonsolidowany przychód przekroczył 20 mln USD w poprzednim miesiącu. Mistral Small 4 jest na Apache 2.0.
- Qwen3.8-Flash-Next. Licencja Qwen Community wymaga osobnej licencji, jeśli firma prowadzi usługę typu „Model as a Service”, czyli udostępnia model innym przez API, albo produkt typu „AI Work Assistant” — samodzielnego asystenta do programowania lub pracy biurowej. Użytek wewnętrzny jest dozwolony, dopóki model i jego wyniki nie są udostępniane osobom trzecim. Qwen3.8-27B jest na Apache 2.0.
- PLLuM „nc”. Starsze warianty polskiego PLLuM z dopiskiem „nc” mają licencję CC BY-NC 4.0, czyli niekomercyjną. Do firmy nadają się PLLuM-12B i PLLuM-4B z serii 2512 (Apache 2.0); historię Bielika i PLLuM opisujemy w tekście o LLM.
Osobna sprawa to chińskie modele open-weight: wagi DeepSeek V4.1-Flash są na licencji MIT, a uruchomione na Twoim serwerze nie wysyłają danych do Chin, w przeciwieństwie do aplikacji DeepSeek, której włoski urząd ochrony danych ograniczył przetwarzanie danych użytkowników z Włoch 30.01.2025.
Ta sama ostrożność dotyczy oprogramowania. Ollama i llama.cpp są na licencji MIT, vLLM — na Apache 2.0. Popularny interfejs Open WebUI ma własną licencję: usunąć jego oznaczenie możesz tylko, gdy z aplikacji korzysta najwyżej 50 osób w ciągu 30 dni, albo po uzyskaniu zgody lub licencji enterprise.
Czy lokalny model jest gorszy od ChatGPT?
Tak, zwykle jest — ale różnica zależy od rozmiaru modelu i od zadania. Epoch AI policzył, że od stycznia 2026 r. najlepsze modele open-weight są w jego zbiorczym indeksie możliwości średnio o cztery miesiące za najlepszymi modelami zamkniętymi. To porównanie najlepszych modeli otwartych, a te są duże i działają na serwerach z kilkoma kartami — nie dotyczy modelu 11 mld na jednej karcie, który mieści się w budżecie małej firmy.
Nasza ocena: model 8–14 mld parametrów dobrze streszcza, klasyfikuje i odpowiada na pytania z dostarczonych dokumentów. Słabiej radzi sobie z rozumowaniem w wielu krokach i z dłuższym pisaniem w złożonych zadaniach. Przed zakupem sprzętu sprawdź model na 30–50 własnych pytaniach z prawdziwych dokumentów, z ustalonymi z góry dobrymi odpowiedziami — to kosztuje kilka godzin wynajętej karty, a nie zakup serwera. Jak takie porównanie zorganizować uczciwie, pokazujemy w teście trzech modeli na polskich zadaniach firmowych.
Serwer AI: ile pamięci potrzebuje model i ile kosztuje sprzęt
O tym, jaki model uruchomisz, decyduje przede wszystkim pamięć karty graficznej. Praktyczna reguła z rozmiarów plików w bibliotece Ollamy: model zapisany w 4 bitach zajmuje ok. 0,6 GB na miliard parametrów, w 8 bitach ok. 1,06 GB. Do tego zapas na kontekst rozmowy — dokumentacja biblioteki accelerate radzi doliczyć do 20% przy wnioskowaniu. Przykłady z biblioteki Ollamy: model 8 mld — 4,9 GB w 4 bitach i 8,5 GB w 8 bitach; 70 mld — 43 i 75 GB. gpt-oss-120b zajmuje 65 GB i według karty modelu mieści się na jednej karcie 80 GB. Bielik 11B w 4 bitach to według tej reguły ok. 7 GB (szacunek nasz).
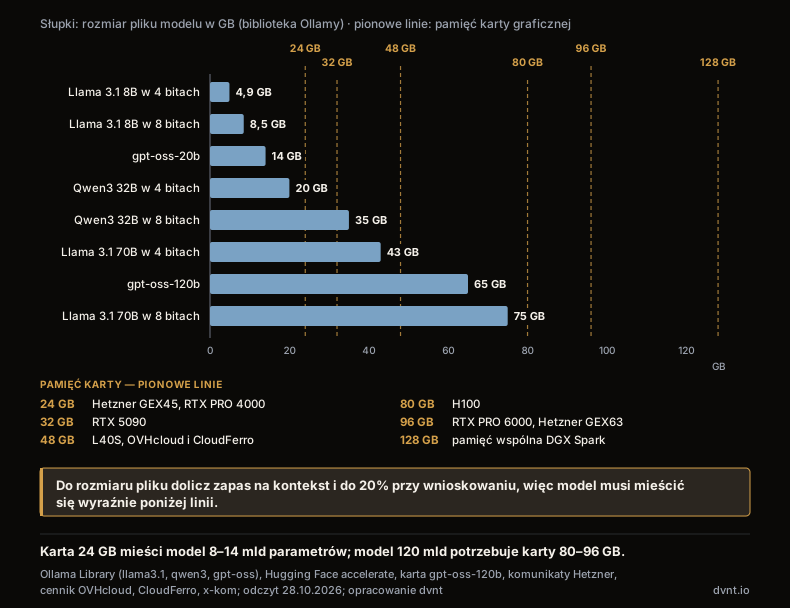
Kupno, ceny sklepowe brutto w x-kom z 28.10.2026: komputer z układem NVIDIA GB10 i 128 GB pamięci wspólnej (DGX Spark i jego odpowiedniki) od 25 849 zł; karta RTX 5090 z 32 GB — 43 999–45 999 zł za samą kartę; RTX PRO 6000 z 96 GB — 74 999–76 999 zł za samą kartę, a gotowe stacje robocze z jedną taką kartą od 124 000 zł. Ceny kart szybko się zmieniają.
Wynajem w UE, ceny netto miesięcznie: Hetzner GEX45 z kartą 24 GB kosztuje 214 EUR, ok. 944 zł, plus jednorazowo 209 EUR; GEX63 z kartą 96 GB 999 EUR, ok. 4 405 zł, plus tyle samo na start. W OVHcloud instancja z L40S 48 GB to 4 608 zł, z H100 80 GB — 8 930 zł. Polski CloudFerro podaje ceny w EUR: L40S ok. 5 860 zł przy umowie miesięcznej i ok. 3 915 zł przy rocznej, H100 ok. 18 711 i 12 239 zł (przeliczenia nasze, kurs NBP z 28.10.2026: 4,4090 zł za euro).
Pełny rachunek własnego serwera — amortyzację, prąd, ludzi — opisujemy w tekście on premise, a modele wynajmu w artykule o chmurze obliczeniowej.
Ile kosztuje lokalne AI w porównaniu z API — rachunek
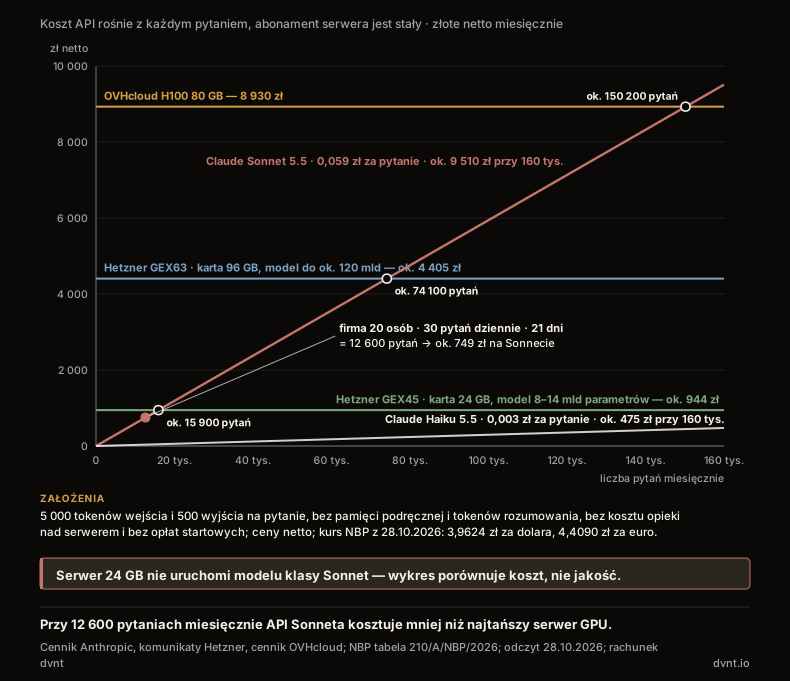
W małej i średniej firmie rachunek za tokeny rzadko uzasadnia własny serwer; uzasadnia go wartość danych. Nasz rachunek, ilustracja z założeniami: pytanie pracownika do asystenta na dokumentach to 5 000 tokenów wejścia (polecenie i kilka fragmentów dokumentów) i 500 tokenów odpowiedzi, bez pamięci podręcznej i bez tokenów rozumowania. Przy cenniku Anthropic — Claude Sonnet 5.5 za 2 USD za milion tokenów wejścia i 10 USD za milion wyjścia — jedno pytanie kosztuje ok. 0,06 zł, a na najtańszym Claude Haiku 5.5 ok. 0,003 zł (kurs NBP z 28.10.2026: 3,9624 zł za dolara).
Firma, w której 20 osób zadaje po 30 pytań dziennie przez 21 dni roboczych, wysyła 12 600 pytań miesięcznie. Na Sonnecie to ok. 749 zł, na Haiku ok. 37 zł. Najtańszy z serwerów z poprzedniej sekcji, GEX45, kosztuje ok. 944 zł netto miesięcznie — i uruchomi model 8–14 mld parametrów, a nie model klasy Sonnet. Sam abonament serwera zrównuje się z kosztem Sonneta przy ok. 15 900 pytaniach miesięcznie dla GEX45, ok. 74 100 dla GEX63 i ok. 150 200 dla H100 w OVHcloud. Przy cenach Haiku progi rosną dwudziestokrotnie.
Do serwera trzeba doliczyć wdrożenie i opiekę. Polscy wykonawcy, którzy publikują ceny (odczyt 28.10.2026, kolejność przypadkowa, to nie ranking):
- Droptica podaje audyt z próbnym wdrożeniem za 1 200–3 500 EUR (2–3 tygodnie), wdrożenie produkcyjne za 7 000–25 000 EUR (4–12 tygodni) i utrzymanie za 700–2 000 EUR miesięcznie; sprzęt kupuje klient.
- RSMobile pisze, że całe wdrożenie prywatnego czatu zamyka się zwykle w 45–95 tys. zł netto, a test na danych klienta trwa 2–4 tygodnie i kosztuje 10–25 tys. zł netto.
- WebyJuice podaje (artykuł z 23.04.2026) 20 000–200 000 zł jednorazowo plus 800–3 500 zł miesięcznie za hosting i utrzymanie, bez informacji, czy to kwoty netto, czy brutto.
To deklaracje wykonawców, a nie średnie rynkowe. Ale już dolna granica Droptiki, ok. 30,9 tys. zł, przekracza trzy lata tokenów Sonneta dla firmy z przykładu (ok. 27 tys. zł, rachunek nasz).
Architektura: lokalny LLM, RAG na dokumentach firmy i hybryda
Działający asystent na dokumentach firmy to cztery klocki, a model jest tylko jednym z nich. Pozostałe trzy to wyszukiwanie w dokumentach, które respektuje uprawnienia (RAG — stażysta nie powinien dostać fragmentu umowy zarządu), interfejs dla pracowników oraz zapis rozmów i kontrola dostępu. Mechanizm i pułapki uprawnień opisujemy w tekście o RAG.
Hybryda, którą zwykle rekomendujemy, wygląda tak:
- Spisujesz, które dane są strategiczne. Tajemnice, przetargi, kod, dokumentacja medyczna lub prawna.
- Te dane idą do modelu u Ciebie albo u dostawcy z UE — poziom trzeci albo czwarty.
- Reszta idzie do najlepszego modelu w chmurze, przez API z regionem UE i umową powierzenia.
- Jedna aplikacja, wybór modelu w konfiguracji. O tym, gdzie trafia pytanie, decyduje reguła w systemie, a nie pamięć pracownika.
Przy własnym serwerze spada na Ciebie to, co w chmurze robi dostawca: aktualizacje modeli i oprogramowania, bezpieczeństwo serwera, filtrowanie treści, kopie zapasowe i monitoring. Automatyzacje wokół asystenta też można trzymać u siebie — na przykład w samodzielnie hostowanym n8n.
Tak działa nasz czat „Vi” na tej stronie: odpowiada na podstawie opublikowanych treści, a model przełączamy w konfiguracji między dostawcami w chmurze i modelem na naszym własnym serwerze. Szczegóły budowy opisujemy w tekście o czacie AI na stronie.
Kiedy własna infrastruktura AI się opłaca, a kiedy nie
Własny serwer AI to odpowiedź na pytanie „kto może zobaczyć te dane”, a nie „jak zapłacić mniej”. Opłaca się, gdy spełniasz co najmniej jeden z pierwszych dwóch warunków i nie trafiasz na żaden z czterech „nie”.
Tak, gdy:
- przetwarzasz dane, na których stoi firma: tajemnice, wyceny przetargowe, kod, dokumentację medyczną lub prawniczą;
- klient albo umowa wymaga przetwarzania w UE u podmiotu z UE;
- masz dużą, stałą liczbę zapytań — dziesiątki tysięcy miesięcznie;
- system musi działać bez internetu, na przykład w zakładzie albo laboratorium;
- zadanie dobrze wykonuje mały model: streszczenia, klasyfikacja, odpowiedzi z dokumentów.
Nie, gdy: zapytań jest mało; zadanie wymaga najlepszego dostępnego modelu; nikt nie zajmie się utrzymaniem serwera; dane i tak są publiczne.
Pierwszy krok nie wymaga sprzętu: spisz, jakie dane w firmie są strategiczne i kto ma do nich dostęp — jak to zrobić, opisujemy w tekście o ochronie danych firmowych. Drugi: sprawdź wybrany model open-weight na 30–50 własnych pytaniach na wynajętej karcie, zanim kupisz serwer.
Najczęstsze pytania o lokalne AI
Czy lokalne AI działa bez internetu?
Tak. Model, baza dokumentów i interfejs mogą działać na serwerze w sieci firmy bez połączenia z internetem. Płacisz za to ręczną pracą: nowe wersje modeli i oprogramowania oraz poprawki bezpieczeństwa trzeba wgrywać samodzielnie.
Czy da się mieć „prywatnego ChatGPT” dla całej firmy?
Tak: model open-weight na Twoim serwerze albo na karcie wynajętej w UE, do tego interfejs czatu i wyszukiwanie w dokumentach. Sprawdź licencję interfejsu — Open WebUI pozwala usunąć swoje oznaczenie tylko przy najwyżej 50 użytkownikach w 30 dni albo z licencją enterprise. Licz się też z tym, że mały model jest słabszy od najlepszych modeli w chmurze.
Czy region UE w Azure, Google Cloud albo AWS wystarczy?
Dla danych osobowych klientów, z umową powierzenia, zwykle tak. Dla informacji, na których stoi firma, region nie zmienia jurysdykcji: CLOUD Act obejmuje dane w posiadaniu amerykańskiego dostawcy niezależnie od tego, gdzie leżą. Wtedy rozważ dostawcę z UE albo własny serwer.
Ile trwa wdrożenie lokalnego modelu?
Według cenników wykonawców z 28.10.2026 test na danych klienta trwa 2–4 tygodnie, a wdrożenie produkcyjne 4–12 tygodni. Najwięcej czasu zajmuje zwykle przygotowanie dokumentów i uprawnień, nie samo uruchomienie modelu.
Czy dotrenować model na dokumentach firmy?
Zwykle nie. Europejska Rada Ochrony Danych zwraca uwagę, że model wytrenowany na danych osobowych może je zawierać, a z wag nie usuniesz ich tak jak rekordu z bazy. Do odpowiedzi na podstawie dokumentów lepiej służy RAG: model dostaje fragmenty z bazy, z której dane usuniesz w każdej chwili.
Czy polski Bielik wystarczy?
Do wielu zadań biurowych po polsku — możliwe. Bielik-11B-v3.0 ma 11 mld parametrów i licencję Apache 2.0, pozwalającą na użytek komercyjny, a w 4 bitach zajmuje według naszego szacunku ok. 7 GB, więc mieści się na karcie 24 GB. Zanim zdecydujesz, sprawdź go na 30–50 własnych pytaniach.
Powiązane artykuły
Sztuczna inteligencja
RAG AI — jak sztuczna inteligencja odpowiada na podstawie dokumentów firmy
RAG AI to sposób, w jaki model językowy odpowiada na podstawie dokumentów firmy. Jak działa, co psuje odpowiedzi, ile kosztuje i jak zacząć bez ryzyka.
Automatyzacja i integracje
API — co to jest? REST API, webhook i OpenAPI wyjaśnione dla firmy
API co to jest: definicja na przykładach NBP, GUS i białej listy VAT, REST API, webhook, OpenAPI, klucze API i bezpieczeństwo integracji.
SaaS i własny produkt
Multi-tenant — co to jest i jak wybrać architekturę SaaS dla wielu klientów
Multi-tenant, czyli wielu klientów w jednej aplikacji: single tenant a multi-tenant, modele silo/pool/bridge, Row Level Security, RODO i wybór modelu dla MVP.
Chmura i bezpieczeństwo
On premise — co to znaczy i kiedy własny serwer w firmie wygrywa z chmurą
On premise, czyli własny serwer w firmie: pełny koszt z amortyzacją i licencjami, koniec wsparcia Windows Server 2016, kiedy wygrywa chmura, a kiedy VPS.
Chmura i bezpieczeństwo
SLA — co to jest i co sprawdzić w umowie SLA z dostawcą chmury
SLA co to jest: ile przestoju mieści się w 99,9%, jak wyglądają SLA AWS, Microsoft i Google, SLO, RPO i RTO oraz 10 rzeczy do sprawdzenia w umowie.
Chmura i bezpieczeństwo
Chmura obliczeniowa — co to jest i czym różnią się IaaS, PaaS i SaaS
Chmura obliczeniowa według definicji NIST: pięć cech, IaaS, PaaS i SaaS, chmura publiczna, prywatna i hybrydowa oraz dane o firmach w Polsce i UE.