
Sztuczna inteligencja14 min czytania2651 słówRedakcja dvnt
Gemini vs ChatGPT vs Claude — nasz test na 10 polskich zadaniach firmowych
Gemini vs ChatGPT vs Claude na 10 polskich zadaniach firmowych: ocena w ciemno, rozrzut powtórzeń, zmyślenia i koszt jednego zadania. Test z 27.10.2026.
Gemini vs ChatGPT, a do tego Claude: który z nich lepiej zrobi pracę w Twojej firmie? Sprawdziliśmy to 27.10.2026 na 10 typowych zadaniach biurowych po polsku, od maila do klienta i faktury w PDF po tłumaczenie i korektę. Przez API przetestowaliśmy po jednym modelu od każdego dostawcy: GPT-6 Astra (OpenAI), Claude Opus 5.5 (Anthropic) i Gemini 4 Argon (Google). Każdy model wykonał każde zadanie trzy razy, a odpowiedzi oceniono w ciemno.
Wszystkie trzy modele zrobiły te zadania prawie bez zarzutu, średnio od 4,86 do 4,97 punktu na 5. Gemini 4 Argon był około 3,7 razy tańszy na zadanie i jako jedyny raz zmyślił fakt. Zamiast kolejnych opinii o Claude AI, ChatGPT czy Gemini dostajesz test z jawnym materiałem, poleceniami, odpowiedziami i ocenami.
Gemini vs ChatGPT vs Claude — krótka odpowiedź z naszego testu
W 10 zadaniach żaden z trzech modeli nie wypadł ogółem lepiej od pozostałych. Jedyna różnica, która przeszła regułę zapisaną przed testem, dotyczy maila do klienta. Reguła brzmi tak: model A jest w zadaniu lepszy od B tylko wtedy, gdy najsłabsze z jego trzech powtórzeń wypadło wyżej niż najlepsze powtórzenie B, i to u obu oceniających osobno. W każdym innym przypadku piszemy „w granicach rozrzutu”.
Zadanie | GPT-6 Astra | Claude Opus 5.5 | Gemini 4 Argon | Wynik według reguły |
|---|---|---|---|---|
Z1 Mail do klienta | 4,97 (4,9–5,0) | 5,00 (5,0–5,0) | 4,67 (4,6–4,7) | Opus 5.5 lepiej niż Argon |
Z2 Odpowiedź na reklamację | 5,00 (5,0–5,0) | 5,00 (5,0–5,0) | 4,90 (4,9–4,9) | w granicach rozrzutu |
Z3 Umowa serwisowa | 5,00 (5,0–5,0) | 4,83 (4,8–4,9) | 5,00 (5,0–5,0) | w granicach rozrzutu |
Z4 Faktura pro forma w PDF | 5,00 (5,0–5,0) | 5,00 (5,0–5,0) | 5,00 (5,0–5,0) | w granicach rozrzutu |
Z5 Wycena cateringu | 5,00 (5,0–5,0) | 4,97 (4,9–5,0) | 4,90 (4,9–4,9) | w granicach rozrzutu |
Z6 Klasyfikacja 15 wiadomości | 5,00 (5,0–5,0) | 5,00 (5,0–5,0) | 5,00 (5,0–5,0) | w granicach rozrzutu |
Z7 Notatka → lista zadań | 4,73 (4,4–4,9) | 5,00 (5,0–5,0) | 4,60 (3,8–5,0) | w granicach rozrzutu |
Z8 Opis produktu | 4,90 (4,9–4,9) | 5,00 (5,0–5,0) | 4,70 (4,7–4,7) | w granicach rozrzutu |
Z9 Tłumaczenie na angielski | 5,00 (5,0–5,0) | 4,87 (4,8–5,0) | 4,87 (4,8–4,9) | w granicach rozrzutu |
Z10 Korekta pisma | 5,00 (5,0–5,0) | 5,00 (5,0–5,0) | 5,00 (5,0–5,0) | w granicach rozrzutu |
Ogółem (średnia z 10 zadań) | 4,96 | 4,97 | 4,86 | brak zwycięzcy |
Błędy krytyczne (z 30 odpowiedzi) | 0 | 0 | 1 | |
Koszt jednego zadania | 0,0324 USD (≈ 0,13 zł) | 0,0336 USD (≈ 0,13 zł) | 0,0088 USD (≈ 0,03 zł) |
Średnia pięciu kryteriów 1–5, obu oceniających i trzech powtórzeń; w nawiasie najsłabsze i najlepsze powtórzenie. Test 27.10.2026: gpt-6-astra, claude-opus-5-5, gemini-4-argon.
Claude vs ChatGPT: w żadnym z dziesięciu zadań różnica nie wyszła poza rozrzut. Claude vs Gemini: tylko w mailu do klienta. Gemini vs ChatGPT: w żadnym zadaniu. Średnią 5,00 Astra i Opus 5.5 dostały w siedmiu zadaniach, Argon w czterech.
Przed testem zapisaliśmy hipotezę w dwóch częściach. Pierwsza się potwierdziła: w dziewięciu zadaniach z dziesięciu różnice zmieściły się w rozrzucie powtórzeń. Druga nie. Zakładaliśmy, że jeśli jakaś różnica wyjdzie poza rozrzut, to w zadaniu z jednoznaczną odpowiedzią (liczby, PDF, pułapki na zmyślenie), a wyszła w mailu do klienta.
Typowe zadania biurowe okazały się dla tych modeli łatwe, a przy takich wynikach skala 1–5 słabo rozróżnia. Różnice widać w szczegółach: w dopowiedzeniach spoza materiału, rejestrze, superlatywach, długości i formacie. Dlatego ważniejsze od wyboru modelu jest to, jak sprawdzasz wynik.
Jak testowaliśmy: 10 zadań, trzy modele, ocena w ciemno
Teksty na tym blogu, a także protokół i materiał tego testu, przygotowujemy z pomocą Claude (Anthropic). Nasz [czat na stronie](posts:6ad602dad484404ef3f0bb48) korzysta z modeli przełączanych między dostawcami, Anthropic i OpenAI, oraz z modelu uruchamianego na naszym serwerze. Dlatego nie ocenialiśmy odpowiedzi sami. Ocena pochodzi z dwóch niezależnych źródeł spoza testu, oznaczonych jako oceniający 1 i oceniający 2.
Stronniczość oceniającego to udokumentowane ryzyko. W pracy Pombala, Reia i Martinsa model oceniający według sztywnej listy kryteriów potrafił o ponad 50% częściej uznać niespełnione kryterium za spełnione, gdy oceniał własną odpowiedź (preprint, odczyt 27.10.2026).
Protokół z zadaniami, kluczem odpowiedzi i regułą różnicy zapisaliśmy przed pierwszym wywołaniem modelu (commit 474d88d1, 27.10.2026). Modele wybraliśmy według reguły z protokołu: od każdego dostawcy ten, od którego jego dokumentacja API każe zacząć, odczytany w dniu testu. OpenAI i Anthropic wskazują taki model wprost. Google ma w grupie Gemini 4 jeden model, Gemini 4 Argon, opisany jako flagowy. Warunki były wspólne: średni poziom rozumowania, limit 16 000 tokenów, bez promptu systemowego i bez narzędzi, w tym wyszukiwania. Fakturę modele dostały jako plik PDF.
Łącznie było 90 wywołań w losowej kolejności między 11:29 a 11:36 UTC, bez ponowień i bez uciętych odpowiedzi. Testowaliśmy przez API, które daje znany identyfikator modelu i stałe ustawienia. Aplikacje ChatGPT, Gemini i Claude mogą odpowiedzieć inaczej, bo dokładają własne ustawienia i zmieniają modele niezależnie od API. Materiał testu jest wymyślony, bez prawdziwych firm, osób i danych.
Wszystkie 90 odpowiedzi, oznaczonych losowymi kodami, ocenił osobno oceniający 1 i osobno oceniający 2. To porównanie modeli AI opiera się na pięciu kryteriach w skali 1–5: poprawności, kompletności, polszczyźnie, formacie i zmyśleniach. Osobno oznaczany był błąd krytyczny opisany w protokole, na przykład wymyślony termin.
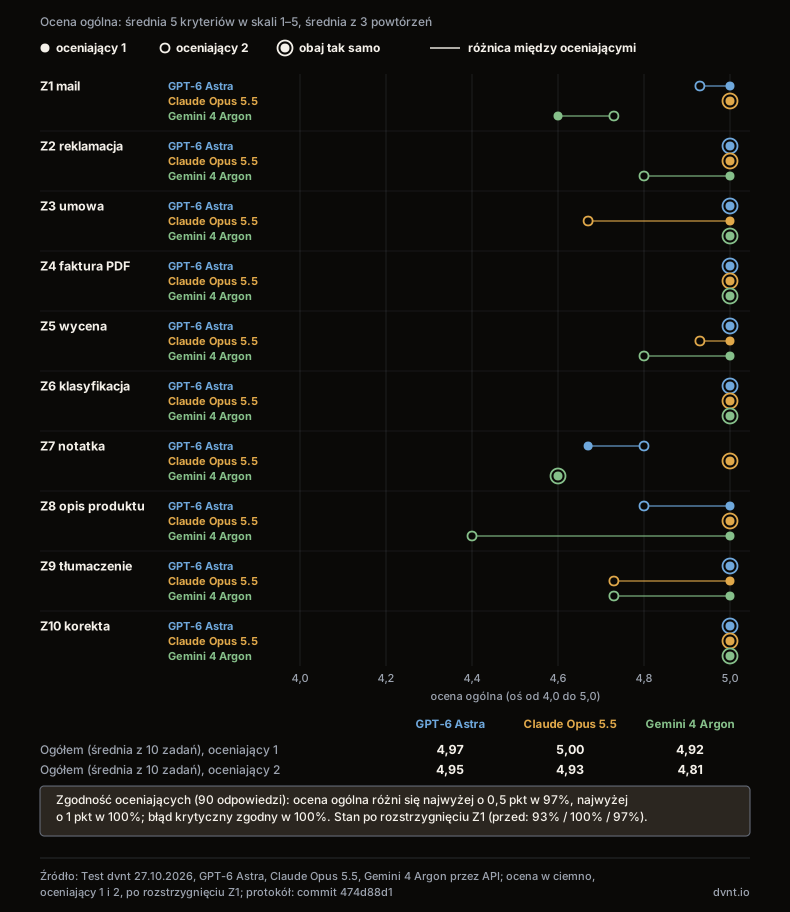
Oceny były zgodne: w 97% odpowiedzi oceny ogólne różniły się najwyżej o 0,5 punktu, we wszystkich najwyżej o 1 punkt, a co do błędu krytycznego oceny zgadzały się w każdej odpowiedzi. Dwie z tych liczb zależą od rozstrzygnięcia jednego sporu. W mailu do klienta oceniający 1 uznał sformułowanie Argona „kod rabatowy 5% na kolejne zakupy” za zmyśloną rekompensatę, czyli błąd krytyczny, a oceniający 2 za drobne dopowiedzenie. Właściciel dvnt uznał, że to nie jest błąd krytyczny, bo rabat 5% na następne zamówienie był w faktach. Decyzja zapadła po odsłonięciu nazw modeli, więc podajemy wyniki sprzed niej i po niej:
- błędy krytyczne Argona u oceniającego 1: 4 przed, 1 po;
- średnia Argona ogółem, z obu oceniających: 4,83 przed, 4,86 po;
- oceny ogólne różniące się najwyżej o 0,5 punktu: 93% przed, 97% po;
- zgodność co do błędu krytycznego: 97% przed, 100% po.
Test ma swoje granice. Jest mały, z jednego dnia, nie jest benchmarkiem i dotyczy tylko tych wersji modeli. Styl, na przykład wzory w notacji LaTeX, może zdradzić model mimo kodów. Tekst do korekty nie przeszedł przed testem przeglądu drugiego czytelnika. Każdą ocenę sprawdzisz na odpowiedziach, ale samej oceny nie powtórzysz z tymi samymi oceniającymi. Uruchomiliśmy też Claude Fable 5.1, ale jego odpowiedzi nie były oceniane. Cały test, 120 wywołań razem z Fable, kosztował 3,98 USD, czyli około 15,7 zł. Wszystkie odpowiedzi z ocenami i uzasadnieniami obu oceniających pobierzesz w pliku test-a1-odpowiedzi-i-oceny.csv, polecenia z kluczem w pliku test-a1-zadania.csv, a fakturę z zadania Z4 w pliku test-a1-z4-faktura-pro-forma.pdf.
Pisanie do klienta: mail, reklamacja i opis produktu
W zadaniach pisarskich wszystkie trzy modele zrobiły to, o co prosiliśmy. Różniły się tym, co dopisały od siebie, i stylem.
Mail o przesuniętej dostawie miał zmieścić się w 150 słowach i podać dwie opcje: poczekać z rabatem 5% na następne zamówienie albo anulować bez kosztów. Opus 5.5 dostał 5,00 w każdym powtórzeniu, Astra 4,97, Argon 4,67. Argon dopisywał rzeczy, których w faktach nie było: „rekompensatę”, „przyczyny niezależne od sklepu”, „termin wysyłki” zamiast terminu dostawy. Astra raz dodała przy terminie zwrotu pieniędzy „od anulowania”, czego w faktach też nie było. Limit długości dotrzymały wszystkie, Argon pisał najdłużej (134–140 słów).
W odpowiedzi na reklamację wolno było opierać się tylko na fragmencie regulaminu. Żaden model nie obiecał zwrotu pieniędzy przed rozpatrzeniem reklamacji ani nie powołał się na przepisy spoza regulaminu. Astra i Opus 5.5 dostały 5,00, Argon 4,90 za brak przecinka w „Dzień dobry Pani Ewo” i raz za pomieszanie liczby pojedynczej z mnogą w podpisie.
W opisie produktu do sklepu różnice dotyczyły stylu. Argon (4,70) sięgał po superlatywy bez pokrycia w parametrach, takie jak „trwałe”, „doskonale”, „idealnie”. Astra (4,90) pisała poprawnie, ale oceniający 2 uznał jej tekst za suchy i monotonny. Opus 5.5 dostał 5,00.
Jeśli piszesz z AI teksty do klientów, sprawdzaj przede wszystkim dopowiedzenia. Błędów językowych było w teście niewiele, częściej model dodawał obietnicę albo cechę produktu, która brzmi naturalnie, ale nie wynika z faktów. Skąd to się bierze, opisujemy w tekście o halucynacjach AI.
Dokumenty: umowa, notatka ze spotkania i faktura w PDF
Dane z dokumentów wszystkie trzy modele wyciągnęły prawie bezbłędnie. Jedyny błąd krytyczny w całym teście padł w notatce ze spotkania.
Zadania z jednoznaczną odpowiedzią (klucz z protokołu) · każdy model 3 powtórzenia
| Zadanie i co sprawdzało | GPT-6 Astra | Claude Opus 5.5 | Gemini 4 Argon |
|---|---|---|---|
| Z3 umowa6 pytań z kluczem; pułapka: waloryzacja, której w umowie nie ma | GPT-6 Astra6/6 ×3 | Claude Opus 5.56/6 ×3 | Gemini 4 Argon6/6 ×3 |
| Z4 faktura PDF11 wierszy; celowy błąd: do zapłaty 3 310,52 zł zamiast 3 300,52 zł | GPT-6 Astra11/11 ×3 błąd wykryty 3/3 | Claude Opus 5.511/11 ×3 błąd wykryty 3/3 | Gemini 4 Argon11/11 ×3 błąd wykryty 3/3 |
| Z5 wycenapułapka: próg darmowego dowozu liczony po rabacie; brutto B 6 362,28 zł, C 7 654,50 zł, różnica 1 292,22 zł, próg 39 osób | GPT-6 Astrapoprawnie ×3 | Claude Opus 5.5poprawnie ×3 | Gemini 4 Argonpoprawnie ×3 |
| Z6 klasyfikacja15 wiadomości, 30 etykiet | GPT-6 Astra30/30 ×3 | Claude Opus 5.530/30 ×3 | Gemini 4 Argon30/30 ×3 |
| Z7 notatka8 zadań do wyciągnięcia ze spotkania | GPT-6 Astraraz 7/8 pominięta odpowiedź na opinię w Google (zadanie bez osoby i terminu) | Claude Opus 5.58/8 ×3 | Gemini 4 Argonraz zmyślenie dopisane zadanie Black Friday z osobami Marek, Kasia; błąd krytyczny u obu oceniających |
| Z10 korekta10 wprowadzonych błędów | GPT-6 Astra10/10 ×3 | Claude Opus 5.510/10 ×3 | Gemini 4 Argon10/10 ×3 |
W umowie serwisowej modele miały odpowiedzieć na sześć pytań, w tym o waloryzację wynagrodzenia, której umowa nie przewiduje. Wszystkie trzy we wszystkich powtórzeniach odpowiedziały, że umowa tego nie określa. Opus 5.5 (4,83) dopisał do streszczenia rzeczy spoza umowy, wzmiankę o RODO i kwotę brutto przy stawce 23%, co oceniający 2 policzył jako dopowiedzenia.
Fakturę pro forma w PDF modele miały przepisać do CSV i sprawdzić sumy. Kwotę do zapłaty celowo zawyżyliśmy w dokumencie o 10 zł: 3 310,52 zł zamiast 3 300,52 zł. Każda z 9 odpowiedzi przepisała 11 z 11 wierszy i wskazała ten błąd. Jeśli pytasz, czy ChatGPT radzi sobie z PDF-em: na jednostronicowej fakturze tak samo dobrze jak Claude i Gemini. Z długimi dokumentami jest trudniej. W niezależnym teście GDP.pdf (Artificial Analysis, długie PDF-y, sędzią model OpenAI) każdy z trzech modeli spełnił wszystkie kryteria zadania w mniej niż co trzeciej próbie (odczyt 27.10.2026). Pracę na wielu dokumentach firmy opisujemy w tekście o RAG.
Z notatki ze spotkania należało wypisać osiem zadań z osobą i terminem albo z adnotacją „nie ustalono”. Opus 5.5 wypisał osiem z ośmiu w każdym powtórzeniu. Astra raz pominęła odpowiedź na opinię w Google, czyli zadanie bez osoby i terminu. Argon w pierwszym powtórzeniu wpisał kampanię na Black Friday i przypisał ją Markowi i Kasi, choć na spotkaniu ustalono tylko „wróćmy do tego w listopadzie”. Obie oceny zgodnie wskazały tu błąd krytyczny, stąd rozrzut Argona od 3,8 do 5,0.
Czy Gemini zmyśla częściej? Z jednej pomyłki na 30 odpowiedzi tego nie wyczytasz, a pomiary niezależnych serwisów się różnią. W zestawieniu Vectary (aktualizacja 22.10.2026, odczyt 27.10.2026), w którym modele streszczają angielskie artykuły, treść niezgodną z dokumentem ma 8,7% streszczeń Astry, 9,9% Opusa 5.5 i 12,1% Argona. Vectara nie podaje, czy te różnice są istotne. W teście AA-Omniscience (odczyt 27.10.2026), który sprawdza, czy model zgaduje, zamiast przyznać się do niewiedzy, Argon robi to wyraźnie rzadziej niż Opus 5.5 i Astra. Kolejność zależy więc od tego, jakie zmyślanie mierzysz, a liczby, osoby i terminy z dokumentu i tak trzeba sprawdzić.
Liczby i porządek: wycena oferty i 15 wiadomości od klientów
Rachunki i klasyfikację wszystkie trzy modele zrobiły bez błędu. Różniły się sposobem podania wyniku.
Wycena cateringu miała pułapkę: próg darmowego dowozu liczy się po rabacie. Wszystkie modele ją ominęły i podały poprawne kwoty: 6 362,28 zł brutto za wariant B, 7 654,50 zł za wariant C, różnicę 1 292,22 zł i próg 39 osób na spotkaniu, od którego dowóz jest darmowy. Astra dostała 5,00, Opus 5.5 4,97 (raz uwaga do formatu), Argon 4,90, bo mimo polecenia „pokaż obliczenia krótko” rozpisywał je obszernie, we wzorach LaTeX.
Klasyfikacja 15 wiadomości od klientów według kategorii i priorytetu dała 30 z 30 poprawnych etykiet u wszystkich modeli we wszystkich powtórzeniach.
Claude, Gemini i ChatGPT po polsku: korekta i tłumaczenie
Jeśli pytasz o Claude AI po polsku albo Gemini po polsku: w korekcie pisma wszystkie trzy modele, razem z ChatGPT, znalazły 10 z 10 wprowadzonych błędów i dostały 5,00.
W tłumaczeniu maila handlowego na angielski różnice dotyczyły rejestru. Zdaniem oceniającego 2 Opus 5.5 (4,87) otwierał i zamykał list zbyt swobodnie jak na ofertę („Hello”, „Kind regards”). Argon (4,87) użył „re-evaluation” tam, gdzie pasowało „re-quote”, i powitania „Good day”, które w brytyjskiej korespondencji brzmi nienaturalnie. Astra dostała 5,00. Żadna z tych różnic nie przeszła reguły.
Niezależne polskie zestawienia mierzą co innego niż nasz test. PLCC Ośrodka Przetwarzania Informacji (aktualizacja 17.10.2026, odczyt 27.10.2026) to 600 pytań o polską historię, geografię, kulturę, sztukę, gramatykę i słownictwo. Argon ma tam średnio 97,33, Astra 96,33, Opus 5.5 92,50. To test wiedzy o Polsce, a nie pracy biurowej, z jednego uruchomienia. Różnica między Argonem a Astrą to 6 pytań z 600. W polskiej tabeli EuroEval (odczyt 27.10.2026) Opusa 5.5 i Argona jeszcze nie ma.
Ten sam model, dwie różne odpowiedzi — dlaczego jeden test w czacie nic nie mówi
Ten sam model z tym samym poleceniem potrafi raz dostać 5,0, a raz 3,8. Jedna rozmowa nie powie Ci więc, który asystent jest lepszy.
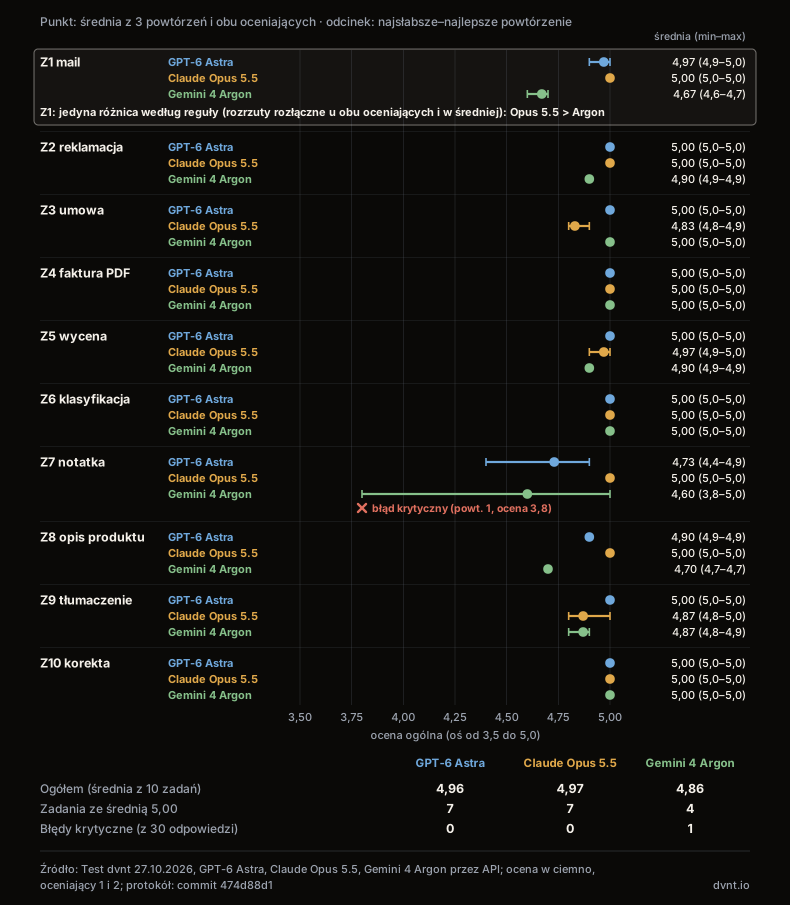
Największy rozrzut wyszedł w notatce ze spotkania: Argon od 3,8 do 5,0, Astra od 4,4 do 4,9. Jeśli sprawdzisz każdy model raz, możesz trafić na najlepsze powtórzenie jednego i najsłabsze drugiego.
Popularna rada „ustaw temperaturę na 0, to wynik będzie powtarzalny” na tych modelach nie działa. Anthropic w przewodniku migracji na Claude Opus 5.5 każe pominąć parametr temperatury i przypomina, że temperatura 0 nie gwarantowała identycznych odpowiedzi także na wcześniejszych modelach. OpenAI każe przy GPT-6 z włączonym rozumowaniem usunąć ten parametr, a Google pisze, że Gemini 4 ignoruje jego ustawienia (odczyt 27.10.2026). Na starszych modelach nawet ustawienia nazywane deterministycznymi dawały wahania trafności do 15% między uruchomieniami. W innej pracy pojedynczy przebieg odwracał kolejność co najmniej jednej pary modeli w 10 z 12 wycinków testu matematycznego względem wyniku z trzech przebiegów (obie prace to preprinty, odczyt 27.10.2026).
Co mówią rankingi — i czemu nie wystarczą do wyboru
Rankingi mierzą co innego niż Twoją pracę i często nie mają jeszcze najnowszych modeli. W kategorii polskiej Areny, w której użytkownicy głosują na lepszą z dwóch odpowiedzi, w stanie na 23.10.2026 (173 510 głosów, odczyt 27.10.2026) nie ma jeszcze Claude Opus 5.5. Gemini 4 Argon ma tam 164 głosy, a przedział miejsc podany przez Arenę sięga od 1 do 79. GPT-6 Astra ma 200 głosów i przedział od 1 do 128. Z tak szerokich przedziałów trudno wyczytać kolejność.
To, że model świetnie robi jedno zadanie, a myli się w podobnie wyglądającym, badacze nazywają poszarpaną granicą możliwości AI. W eksperymencie z 758 pracownikami wiedzy, przeprowadzonym z Boston Consulting Group (2023, GPT-4), osoby korzystające z AI robiły zadania w zasięgu modelu szybciej i lepiej. W zadaniu spoza tego zasięgu miały jednak o 19% mniejszą szansę na poprawne rozwiązanie niż osoby bez AI (odczyt 27.10.2026). W naszym teście model, który bezbłędnie rozliczył fakturę, w notatce dopisał zadanie, którego nikt nie ustalił.
Który model do jakiej pracy w firmie — jak wybrać
Do zadań z tego testu nadaje się każdy z trzech modeli. Wybieraj więc po koszcie i po tym, jak sprawdzisz wynik.
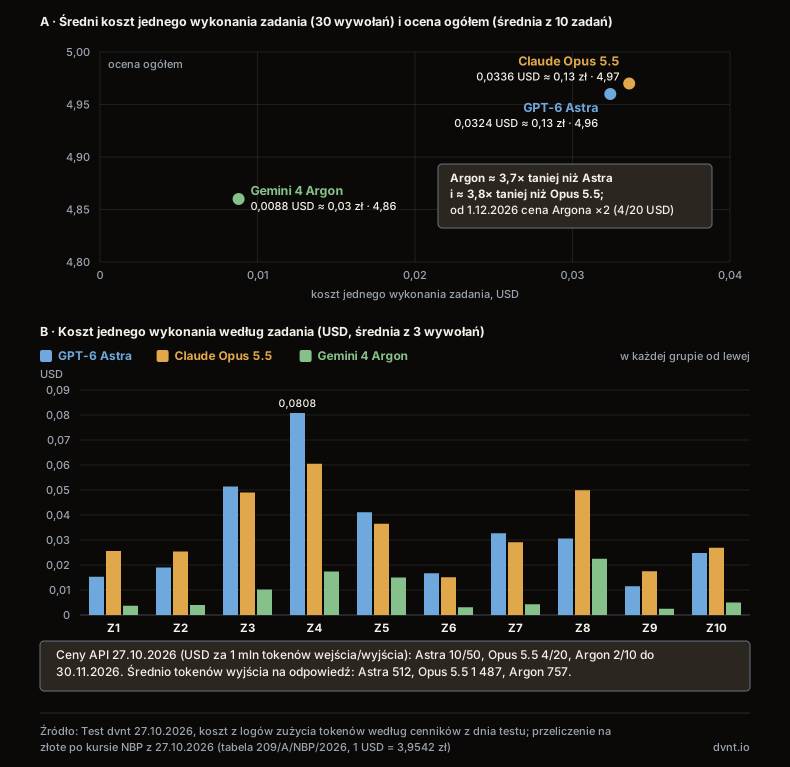
Koszt liczyliśmy z logów zużycia tokenów, a nie z ceny za milion tokenów, bo dostawcy różnie dzielą tekst na tokeny. Astra i Opus 5.5 kosztowały podobnie, około 0,13 zł za zadanie, choć Astra ma wyższy cennik. Opus 5.5 zużywał za to średnio 1 487 tokenów wyjścia na odpowiedź, a Astra 512. Argon kosztował około 0,03 zł, ale Google podwaja jego cenę od 1.12.2026 (odczyt 27.10.2026), więc ta przewaga zmaleje mniej więcej o połowę. Przy kilkuset zadaniach miesięcznie różnica między modelami to kilkadziesiąt złotych. Przy tysiącach wywołań w automatyzacji zaczyna się liczyć.
Lista kontrolna z wyników testu:
- Mail i odpowiedź klientowi: czy model nie dopisał rabatu, rekompensaty ani powodu, których nie podałeś.
- Opis produktu: czy każda cecha jest na Twojej liście parametrów i czy w tekście nie ma superlatyw bez pokrycia.
- Umowa i notatka: czy model przyznaje, że umowa czegoś nie określa, i czy na liście nie ma zadań, których nikt nie ustalił.
- PDF i liczby: sumy i kwoty do zapłaty przelicz sam.
- Tłumaczenie: czy rejestr pasuje do oferty handlowej.
Wynik nie dotyczy darmowych planów, bo pracują w nich inne modele: GPT-6 Luna w ChatGPT Free, Flash-Lite w Gemini bez subskrypcji, Sonnet i Haiku w Claude Free (odczyt 27.10.2026). Ceny planów i to, co dzieje się z danymi firmy, opisujemy w porównaniu ChatGPT Business, Copilota i Gemini dla firm. Jak polecenie wpływa na odpowiedź, piszemy w tekście o prompt engineeringu, a pytania przed wyborem modelu do zadania zebraliśmy w artykule o modelach językowych. Jeśli AI ma na stałe pracować w procesach firmy, mały test na własnych zadaniach to dobry pierwszy krok przed wdrożeniem AI w firmie.
Oceń sam: trzy odpowiedzi bez nazw modeli
Pod tym akapitem możesz zagłosować w ciemno w trzech zadaniach: mailu do klienta, odpowiedzi na reklamację i opisie produktu. Przy każdym zobaczysz trzy odpowiedzi z pierwszego powtórzenia, w losowej kolejności, a nazwę modelu po oddaniu głosu. Wyniki pokażemy od 50 głosów na zadanie, w procentach, jako preferencję czytelników, osobno od ocen z testu. Gdy każde zadanie zbierze co najmniej 50 głosów, dopiszemy w tym miejscu, co wybrali czytelnicy i czy zgadza się to z oceną w ciemno.
Od czego zacząć test asystenta AI we własnej firmie
- Wybierz trzy zadania, które powtarzają się u Ciebie co tydzień.
- Przygotuj do nich materiał bez danych klientów i uruchom każde zadanie w dwóch asystentach po dwa albo trzy razy. Porównuj najsłabsze odpowiedzi, bo to one kiedyś trafią do klienta.
- Poproś kogoś, żeby wkleił Ci odpowiedzi bez nazw asystentów, i oceń je według listy kontrolnej powyżej.
Najczęstsze pytania o ChatGPT, Gemini i Claude
Co lepsze, Gemini czy ChatGPT?
W naszym teście (27.10.2026, 10 polskich zadań, przez API) żaden z nich nie wypadł lepiej: w każdym zadaniu różnica między Gemini 4 Argon a GPT-6 Astra mieściła się w rozrzucie trzech powtórzeń. Argon był około 3,7 razy tańszy, ale raz zmyślił zadanie w notatce ze spotkania.
Czy Claude dobrze pisze po polsku?
W naszym teście tak: Claude Opus 5.5 znalazł w korekcie pisma 10 z 10 wprowadzonych błędów, a w mailu, odpowiedzi na reklamację i opisie produktu dostał średnio 5,00. Uwagi dotyczyły tonu tłumaczenia na angielski i dopowiedzeń w streszczeniu umowy.
Czy darmowa wersja ChatGPT, Gemini albo Claude da te same wyniki?
Tego nie testowaliśmy. W darmowych planach odpowiadają inne modele: w ChatGPT Free GPT-6 Luna, w Gemini bez subskrypcji Flash-Lite, w Claude Free Sonnet i Haiku (cenniki dostawców, odczyt 27.10.2026).
Dlaczego ten sam prompt daje za każdym razem inną odpowiedź?
Bo modele generują tekst z elementem losowości, a temperaturą już tego nie wyłączysz: Anthropic przy Claude Opus 5.5 i OpenAI przy GPT-6 z rozumowaniem każą pominąć ten parametr, a Gemini 4 go ignoruje. U nas ten sam model w tym samym zadaniu dostawał od 3,8 do 5,0.
Czy mogę w takim teście wkleić dokumenty firmy?
Lepiej nie, dopóki nie sprawdzisz warunków swojego planu. My użyliśmy wyłącznie wymyślonego materiału. Co plany prywatne i firmowe robią z danymi, opisujemy w porównaniu planów dla firm.
A co z Copilotem?
Nie testowaliśmy go. Microsoft udostępnia w Copilocie modele zewnętrznych dostawców, takich jak Anthropic i OpenAI, więc mierzylibyśmy modele tych samych firm w innej obudowie. Plany Copilota opisujemy w porównaniu asystentów AI dla firm.
Czy rankingi typu Arena wystarczą do wyboru modelu?
Nie, są tylko tłem z datą. Arena zbiera głosy użytkowników porównujących dwie odpowiedzi w dowolnych rozmowach, a w jej kategorii polskiej (stan na 23.10.2026) nie ma jeszcze Claude Opus 5.5. Lepiej sprawdzą się trzy Twoje zadania, każde uruchomione dwa albo trzy razy.
Powiązane artykuły
Sztuczna inteligencja
Chatbot na stronę — kiedy czat AI ma sens i ile kosztuje
Chatbot na stronę firmy: kiedy czat AI ma sens, ile kosztuje rozmowa, co musi powiedzieć o sobie (AI Act) i co może pójść źle. Na przykładzie naszego czatu.
Sztuczna inteligencja
Prompt engineering — co to jest i jak pisać prompty w firmie
Prompt engineering w firmie: co to jest, jak pisać prompty, szablony do procesów i kiedy samo polecenie nie wystarczy, a potrzebny jest RAG albo agent AI.
Sztuczna inteligencja
Lokalne AI w firmie — własny serwer, chmura w UE czy API? Koszty, prawo i jakość
Lokalne AI w firmie: kiedy własny serwer albo chmura w UE mają sens, ile kosztuje GPU wobec API, co zmienia region UE i które modele open-weight wolno użyć.
Sztuczna inteligencja
MCP (Model Context Protocol) — co to jest i co daje firmie
Model Context Protocol (MCP) łączy asystentów i agentów AI z systemami firmy. Jak działa serwer MCP, co daje, jakie ma ryzyka i kiedy warto go budować.
Automatyzacja i integracje
n8n — co to jest i kiedy ma sens w firmie
n8n co to jest? Narzędzie do automatyzacji z węzłami AI, w chmurze lub na własnym serwerze. Licencja, ceny, bezpieczeństwo i porównanie z Make i Zapier.
Sztuczna inteligencja
Jak stworzyć agenta AI w firmie — od procesu do pierwszej działającej wersji
Jak stworzyć agenta AI w firmie krok po kroku: proces, narzędzia i uprawnienia, człowiek w pętli, limity kosztu, testy i ochrona przed prompt injection.